Analysis Services (SSAS) 多維模型中的排序規則直接影響報表顯示順序、鑽取行為與使用者體驗。本文深入解析四大關鍵設定面向,助您避開常見陷阱。
一、是否區分大小寫
- 區分大小寫:'a' < 'A' < 'b' < 'B'…,'Name' 與 'NAME' 分離排序
- 不區分大小寫:視為相同字元,'Name'、'NAME' 混排
- 商務智慧場景:維度屬性常含混合大小寫 (如 ERP 代碼、使用者輸入),建議預設不區分,除非業務明確要求區分
- 設定位置:安裝精靈 排序規則設定 頁籤 → 區分大小寫 核取方塊;或安裝後 → Analysis Server 屬性 → 語言/排序規則 → 區分大小寫
二、BIN1 vs BIN2:二進位排序的效能與行為差異
| 特性 | BIN1 (Binary) | BIN2 (Binary Code Point) |
|---|
| 排序依據 | 字元定義的位元模式 | Unicode 碼位 |
| 大小寫/重音 | 區分 (忽略上述大小寫設定) | 依碼位順序,大小寫通常分離 |
| 大量資料效能 | 較好 (簡單位元比較) | 略低,但支援已排序資料的二分搜尋 |
| 已排序報表查詢 | 需重新排序 | 無需重排,直接二分搜尋 |
| 非 Unicode 資料 | 同 BIN1 行為 | 退回 BIN1 行為 |
建議:報表導向、已預排序資料集 → BIN2;原始資料探勘、效能優先 → BIN1。設定同樣在安裝精靈或 Server 屬性中,選擇 二進位 (BIN1) 或 二進位 2 (BIN2)。
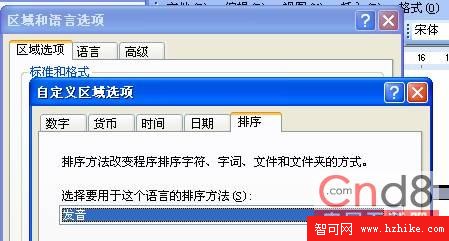
三、Windows 排序規則:OS 層級覆蓋資料庫設定
啟用後,排序依據 Windows 控制台 → 區域與語言選項,而非 SSAS 內部設定。
- 二進位資料:強制使用基於地區設定的編碼值順序 (提升效能)
- Unicode 資料:固定採用 Unicode 碼位排序,**忽略** 區域自訂與資料庫設定
- 非 Unicode 資料:依 ANSI 代碼頁碼位比較
- 複雜度高:OS 設定、資料庫排序規則、預設 Unicode 行為三者交互,務必在測試環境完整驗證
四、多語言環境下的排序策略
跨國企業常面臨:中文、日文、韓文資料混存,需統一報表排序。
- 資料轉換法:ETL 階段將所有語言轉為單一語系 (如 Unicode 正規化),再排序。R2 提供匯入/匯出轉換工具。
- Windows 排序規則法:所有分支共用同一台 SSAS 伺服器,天然使用同一組 Windows 排序,避免不一致。
- CaptionColumn 屬性法 (推薦):在維度屬性設定
CaptionColumn 指定排序欄位,**優先級高於 Windows 排序**,可針對特定屬性自訂多語言排序邏輯。
排序規則一旦部署難以變更 (需重建資料庫/多維資料集),請在專案初期完成 多語言測試矩陣,確認所有目標語系的顯示順序符合業務預期。
- 上一篇文章: SQL Server 索引優化實戰:從欄位選擇、叢集策略到碎片整理
- 下一篇文章: SQL Server 2008 R2 報表服務 (SSRS) 互動式排序完整實作指南
Copyright ©
程式碼之家 All Rights Reserved