痛點:現實數據生來「有問題」
拼寫錯誤、截斷、缺失標記、空字段、意外縮寫——ETL 階段消耗項目 60%+ 時間成本。SQL Server 2005 DTS 引入模糊查找與模糊分組轉換,無需領域專家規則腳本,即能應對常見數據質量問題。
核心能力對比
模糊查找
- 輸入記錄 → 匹配引用表中的標準記錄
- 容錯匹配,返回最佳匹配 + 質量度量
- 例:銷售交易客戶信息與主檔不完全匹配,仍返回最佳候選 + 相似度分
模糊分組
- 識別表中對應同一實體的記錄群
- 群內記錄不完全相同但高度相似
- 例:清洗客戶主檔,合併重複實體記錄
技術優勢:超越傳統方法
- 自定義距離函數:融合編輯距離、Token 數/順序、相對頻率,辨別力遠超全文搜索
- 純 Token 驅動:無語言依賴組件(Soundex 依賴語音規則)
- 抗變換干擾:非單純編輯距離,能識別高階模式
- DTS 原生集成:設計器內拖拽即用,零/少代碼
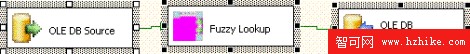
模糊查找入門:最簡包結構
單一 Data Flow Task:Source → Fuzzy Lookup Transform → Destination
後續內容預告
- 分步使用指南
- 實現細節與效能調優參數
- 列寬、層次結構、Token 處理選項等進階配置
- 領域知識注入提升準確率的方法
本文旨在補充線上書籍,詳細參數請參考官方文檔。