資料表出現重複列會導致查詢與統計不準。傳統游標逐列比對刪除,資料量達百萬列時執行極慢,堪稱噩夢。
假設產品資訊表 Products:
CREATE TABLE Products (
    ProductID int,
    ProductName nvarchar(40),
    Unit char(2),
    UnitPrice money
);
圖示資料中 Chang、Tofu 重複。目標:刪除重複,保留一筆。
CREATE TABLE Products_temp (
    ProductID int,
    ProductName nvarchar(40),
    Unit char(2),
    UnitPrice money
);
在企業管理員中對 Products_temp 右鍵 →「所有工作」→「管理索引」→「新增」,於索引選項勾選 忽略重複鍵值(IGNORE_DUP_KEY = ON)。
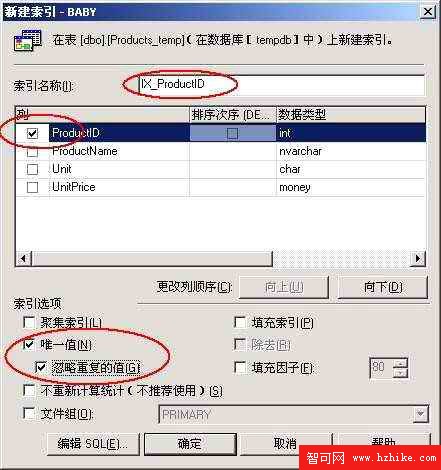
圖 2:設定忽略重複鍵值
INSERT INTO Products_temp SELECT * FROM Products;
訊息顯示 已忽略重複的鍵。,暫存表已無重複列。
TRUNCATE TABLE Products;
INSERT INTO Products SELECT * FROM Products_temp;
DROP TABLE Products_temp;
完成!此法避免游標遍歷,大幅提升效能,適合大量資料去重複。