核心議題概覽
- 查詢計劃概述
- 查詢解析
- 查詢優化器
- 查詢執行
- 查詢計劃的重用
兩大引擎架構分工
SQL Server 內部分為 關係引擎 與 儲存引擎:
- 關係引擎:負責解析、綁定、優化、生成執行計劃 (二進制格式)。
- 儲存引擎:接收計劃,執行物理存取、鎖管理、索引維護、交易處理、日誌寫入,最終回傳或更新資料。
本系列聚焦關係引擎內部機制,特別是執行計劃的生成與重用。
階段一:查詢解析 — 從文本到邏輯樹
1. 語法解析
提交的 T-SQL 進入關係引擎,首先進行 詞法與語法分析。通過則生成 解析樹,反映查詢的邏輯步驟結構 (類似編譯器的語法樹)。
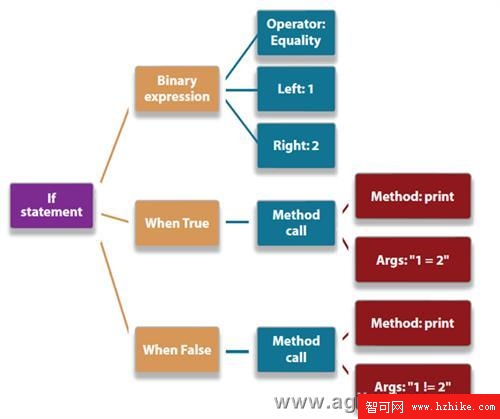 解析樹結構示意
2. 僅優化 DML 陳述句
SELECT / INSERT / UPDATE / DELETE / MERGE 才會進入優化流程。DDL (CREATE TABLE 等) 與工具命令 (DBCC, SET 等) 不經優化器,直接執行。
3. 繫結器做語義綁定
解析樹傳遞給 Algebrizer (繫結器):
- 驗證資料表、欄位名稱是否存在於目錄中。
- 解析別名、推導運算式資料型別 (自底向上:常數/欄位 → 運算式 → 完整查詢)。
- 輸出 二進制「查詢處理樹」,傳遞給優化器。
階段二:查詢優化器 — 成本導向的計劃搜尋
核心輸入
- 查詢處理樹 (邏輯需求)
- 統計資料 (資料分佈、密度、直方圖) — 即「資料的資料」/ Metadata
優化器決策範例
- 是否使用索引 (Index Seek vs Scan)
- 聯接演算法選擇 (Nested Loops / Hash Match / Merge Join)
- 聯接順序重排
- 甚至改寫邏輯:
LEFT JOIN 在語意等價下轉為 INNER JOIN
成本模型與搜尋策略
- 成本基礎優化器:估算每個候選計劃的資源消耗 (CPU、I/O、記憶體),選擇 估計成本最低 者。
- 統計資料預設 自動更新,調優時可手動
UPDATE STATISTICS。
- 表變數無統計資料 → 優化器假設 1 列,極易產生劣質計劃;臨時表 (#Table) 有統計資料,優化較準確。
- 搜尋空間極大時,優化器 不窮盡枚舉,採用啟發式規則尋找「夠好」的計劃 (接近理論最小值),而非絕對最優。
- 估計成本 = 預估完成時間,不一定等於實際資源消耗最少。
階段三:查詢執行 — 從估計到實際
優化器產出 估計執行計劃 (含運算子、基數估估、成本),傳遞給儲存引擎。儲存引擎根據實際執行狀態 (可用記憶體、平行度、參數值) 產生 實際執行計劃 並驅動物理運算子執行。
階段四:查詢計劃重用 — 避免重複編譯的關鍵
為何要重用?
編譯計劃消耗大量 CPU 與時間 (特別是複雜查詢)。「過度編譯」是常見效能殺手。
Plan Cache (計劃緩衝區) 機制
- 計劃生成後緩存於記憶體 (Plan Cache)。
- 優化器產出估計計劃前,先查 Plan Cache 是否存在 完全匹配 的實際計劃 (含參數化形式、SET 選項、資料庫上下文等)。
- 命中 → 直接重用,跳過優化與編譯。
快取策略與淘汰條件
- 原則:每個查詢僅保留一份計劃,除非優化器判定平行計劃更優,則同時緩存序列與平行兩份。
- 淘汰機制 (類似 .NET GC 的 LRU):
① 系統記憶體壓力,強制釋放。
② 計劃近期使用計數為 0。
③ 計劃不被當前連線引用。
下一篇預告
將深入剖析 執行計劃運算子細節、基數估估誤差診斷、參數嗅探與計劃穩定化技術。