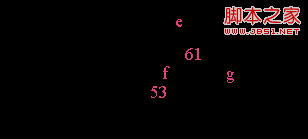首頁
編程語言
C語言|JAVA編程
Python編程
網頁編程
ASP編程|PHP編程
JSP編程
數據庫
MYSQL數據庫|SqlServer數據庫
Oracle數據庫|DB2數據庫
您现在的位置: 程式碼之家 >> 數據庫知識 >  >> SQL Server 資料庫 >> 關於SqlServer

B 樹與 B+ 樹深度解析:從資料結構原理到 MySQL/InnoDB 索引實戰

     編輯:關於SqlServer

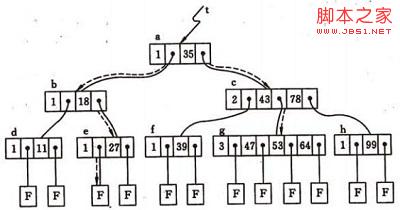
B 樹(B-Tree)定義與特性

m 階 B 樹滿足:

  1. 每節點至多 m 棵子樹
  2. 根節點非葉時至少 2 棵子樹
  3. 非根非葉節點至少 ⌈m/2⌉ 棵子樹
  4. 節點內鍵值有序:(n, A0, K1, A1, ..., Kn, An),Ki < Ki+1,指標 Ai 指向鍵值介於 Ki 與 Ki+1 之間的子樹
  5. 所有葉節點同層,深度一致
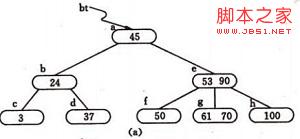
四階 B 樹範例

查找、插入、刪除演算法

查找

從根節點二分查找鍵值 → 依指標下降 → 達葉節點仍未找到則失敗。I/O 次數 = 樹高 h。

插入與分裂

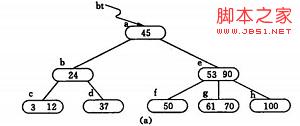
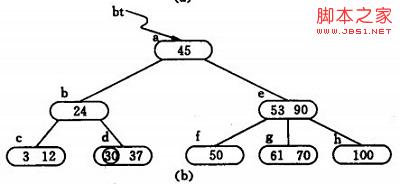
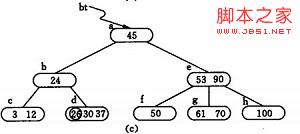
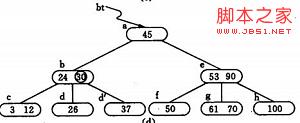
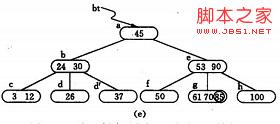
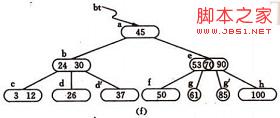
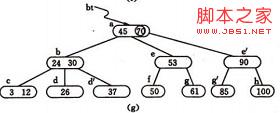
新鍵值插入葉節點,若超過 m-1 則分裂:中位鍵值上移父節點,左右分成兩節點。可能觸發連鎖分裂至根,樹高 +1。

插入分裂示意 插入 30 插入 26 分裂 插入 26 完成 插入 85 步驟1 插入 85 步驟2 插入 85 完成

刪除與合併

刪除葉節點鍵值,若低於 ⌈m/2⌉-1:

  1. 兄弟節點足夠 → 借鍵值(父節點鍵值下移,兄弟最小/最大上移)
  2. 兄弟也不足 → 與兄弟合併,父節點鍵值下移,可能遞歸向上
刪除 12 刪除 50 借鍵 刪除 53 合併 刪除 37 連鎖合併

B+ 樹:資料庫索引的最佳化變體

關鍵差異

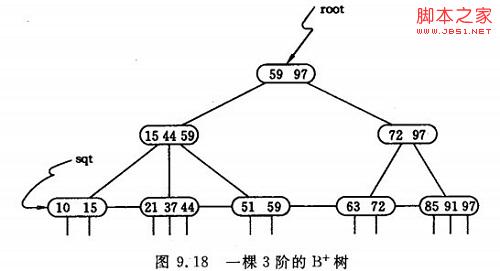
  1. 非葉節點僅存鍵值與指標,不存資料
  2. 葉節點包含所有鍵值與資料指標,並以雙向鏈表串聯
  3. 非葉節點可視為稀疏索引,葉節點為稠密索引
三階 B+ 樹

優勢

  • 範圍查詢、全表掃描只需遍歷葉層鏈表,無需回溯
  • 非葉節點更瘦,單頁容納更多鍵值 → 樹高更低 → I/O 更少
  • 所有查詢路徑長度固定(根到葉),效能穩定

磁碟 I/O 與局部性原理:為什麼資料庫選 B+ 樹

  • 磁碟預讀以「頁」(通常 4KB/16KB)為單位
  • 將節點大小設為 1 頁 → 讀 1 節點 = 1 次 I/O
  • B+ 樹階數 m 極大(InnoDB 約 1200),樹高 h 通常 ≤ 3
  • 查找 I/O = h-1(根節點常駐記憶體)≈ 2 次
  • 紅黑樹 h ≈ log₂N,節點分散無法利用預讀,I/O 次數遠高於 B+ 樹

MySQL 存儲引擎索引實作差異

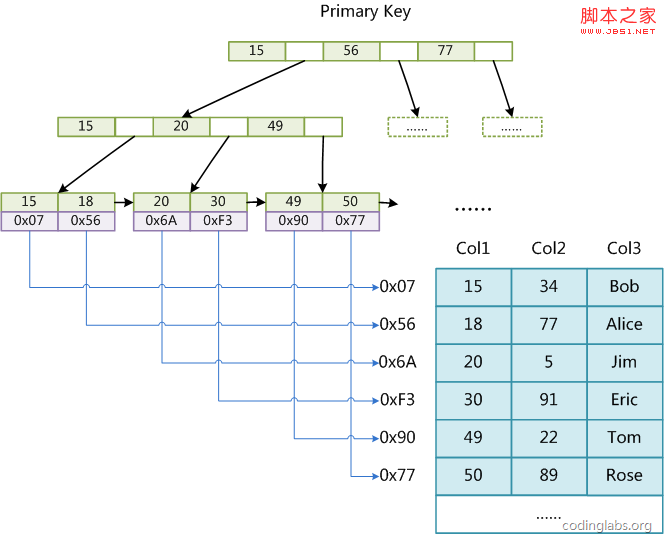
MyISAM:非聚集索引

  • 索引檔與資料檔分離
  • 主鍵索引葉節點存資料行指標
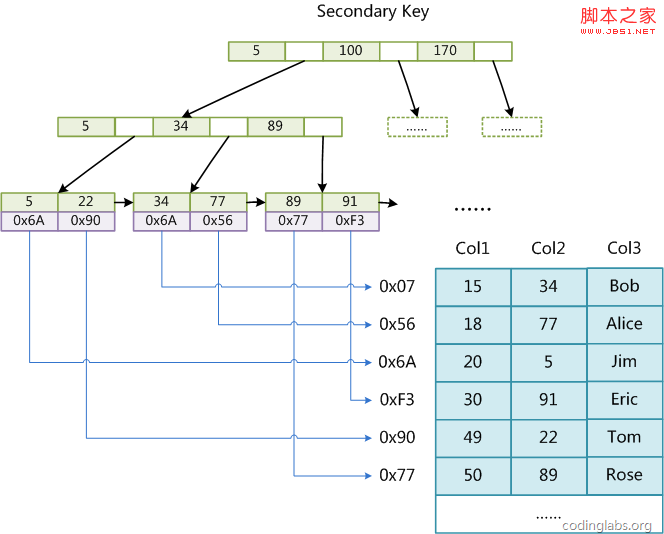
  • 輔助索引結構相同,鍵值可重複
MyISAM 主鍵索引 MyISAM 輔助索引

InnoDB:聚集索引

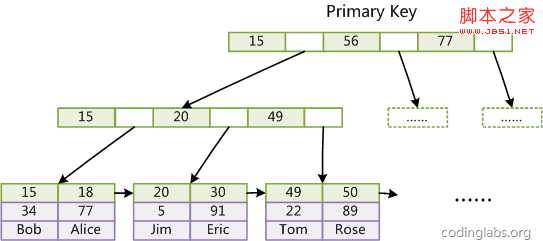
  • 資料檔即主鍵索引(Clustered Index),葉節點存完整行資料
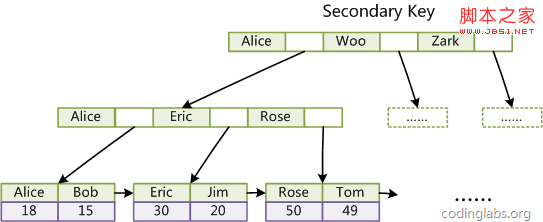
  • 輔助索引葉節點存主鍵值而非指標
  • 查詢輔助索引需「回表」:輔助索引 → 主鍵值 → 主鍵索引 → 行資料
InnoDB 主鍵索引 InnoDB 輔助索引

實務啟示

  1. 主鍵宜短(INT/BIGINT),避免 UUID/長字串 → 輔助索引體積暴增
  2. 主鍵宜單調遞增(自增 ID),避免頁分裂
  3. 覆蓋索引可避免回表,大幅提升效能
  1. 上一篇文章:
  2. 下一篇文章:
Copyright © 程式碼之家 All Rights Reserved