索引核心觀念
索引是加速資料檢索的關鍵結構,如同書本目錄讓讀者快速定位頁面。資料庫引擎透過索引避免全表掃描,直接定位符合條件的資料列,大幅縮短查詢回應時間。
索引特性與權衡
| 優點 | 缺點 |
|---|
| 加快 SELECT、JOIN、GROUP BY、ORDER BY 查詢速度 |
增加 INSERT/UPDATE/DELETE 維護成本 |
| 唯一性索引保障資料唯一性 |
佔用額外儲存空間(叢集索引更大) |
| 加速參考完整性檢查(外鍵關聯) |
索引建立與重建耗時,隨資料量增長而增加 |
| 提供查詢最佳化器更多存取路徑選擇 |
過多索引反而干擾最佳化器決策 |
索引分類總覽
1. 建立方式
- 直接建立: `CREATE INDEX idx_col ON tbl (col)`
- 間接建立: 定義 PRIMARY KEY 或 UNIQUE 條件約束時自動建立。
2. 唯一性
- 一般索引: 允許重複值。
- 唯一索引: `CREATE UNIQUE INDEX ...` 保證欄位值唯一,叢集與非叢集均適用。
3. 欄位組合
- 單欄索引: 單一欄位。
- 複合索引: 多欄位(最多 16 欄),如 `CREATE INDEX idx_name ON users(firstname, lastname)`。前導欄位須為查詢最常用欄位,否則索引失效。
4. 叢集 vs 非叢集
- 叢集索引 (Clustered): 資料實際儲存順序與索引順序一致,每張表僅能有一個。`CREATE CLUSTERED INDEX ...`。
- 非叢集索引 (Nonclustered): 索引與資料分離,葉層存放書籤指向資料列,可建立多個。`CREATE NONCLUSTERED INDEX ...`。
實戰索引設計原則
- 低更新、高查詢、大量重複值 → 適合叢集索引(如類別、狀態碼)。
- 多欄位常一起查詢且各含重複值 → 考慮複合索引,前導欄位為選擇性最高者。
- WHERE 子句避免對欄位運算:`WHERE substring(col,1,4)='5378'` 導致掃表;改寫為 `WHERE col LIKE '5378%'` 可用索引。
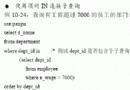
- IN / OR 易導致索引失效:優化器常轉為工作表處理。若重複值少,拆分為多條件 UNION ALL 可改善。
- 善用預存程序:參數化查詢促進執行計畫重用,減少編譯開銷。
- 連接順序與索引配合:查詢最佳化器依統計資料估算成本;確保連接欄位有索引,大表駕小表原則(外層匹配行數 × 內層查找次數最小)。
常見陷阱提醒
- 對索引欄位使用函數、運算式 → 全表掃描。
- 複合索引前導欄位未出現在 WHERE 條件 → 索引不被使用。
- 過度索引:維護成本超過查詢收益。
- 忽略統計資料更新:導致最佳化器誤判。
總結
索引是把雙面刃,善用則查詢飛快,濫用則寫入龜速。核心在於「理解查詢模式、評估選擇性、平衡讀寫比例、定期檢視執行計畫」。建議配合查詢最佳化器圖形化工具與 `SET STATISTICS IO/TIME ON` 實測驗證,以數據導向調整索引策略。