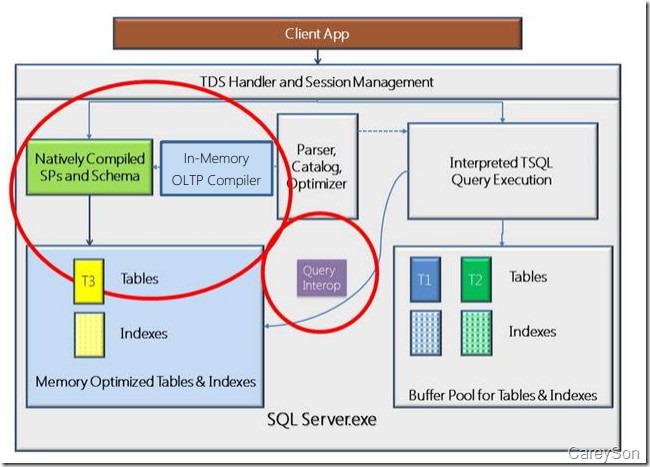
SQL Server 2014 最令人矚目的創新是記憶體內部 OLTP 引擎(代號 Hekaton)。不同於傳統磁碟基礎引擎,Hekaton 專為記憶體常駐資料設計:採用無鎖資料結構、樂觀並發控制 (MVCC) 與原生編譯預存程序,在相同硬體上可提供數十倍的交易處理吞吐量。
客戶端透明性:應用程式完全感知不到 Hekaton 存在,連線字串、驅動程式、查詢語法均無需變更。
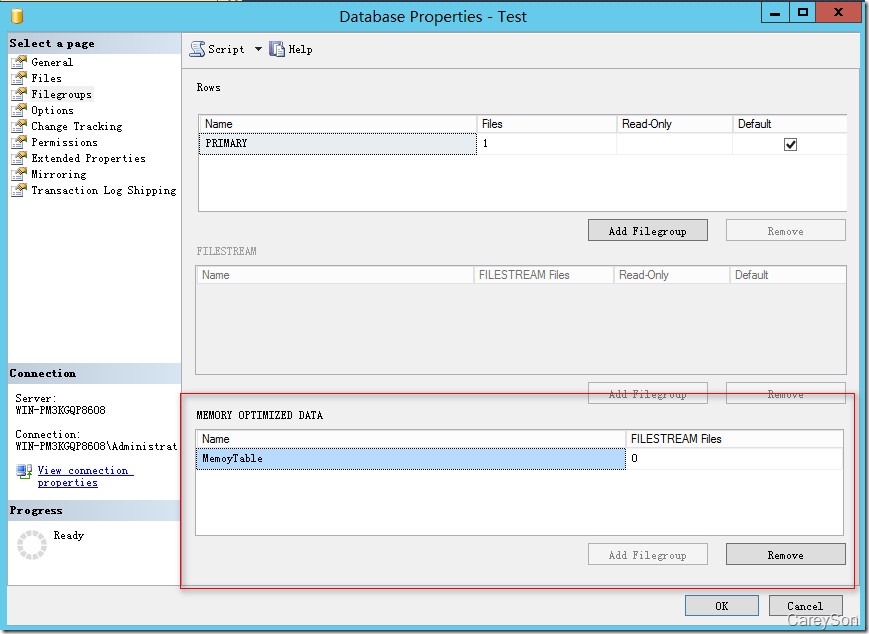
ALTER DATABASE TestDB
ADD FILEGROUP TestDB_MemoryOptimized CONTAINS MEMORY_OPTIMIZED_DATA;
GO
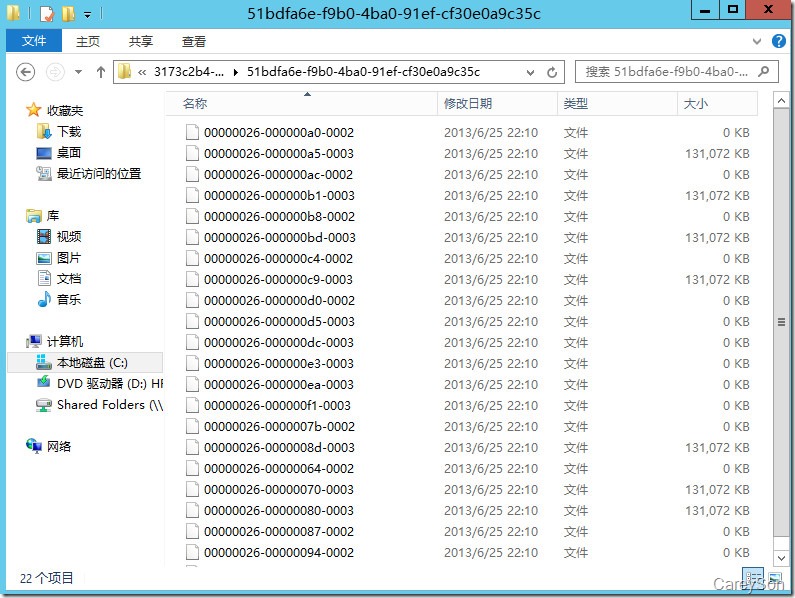
ALTER DATABASE TestDB
ADD FILE (NAME = 'TestDB_MO', FILENAME = 'D:\MO_Data')
TO FILEGROUP TestDB_MemoryOptimized;
GO
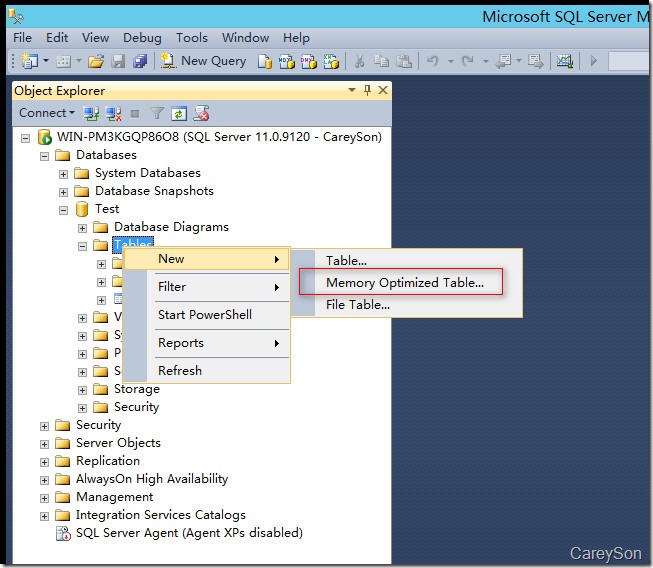
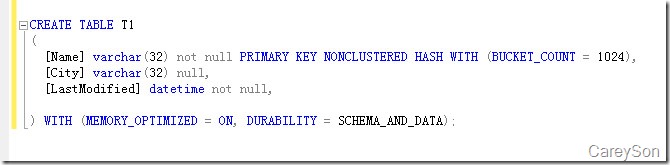
CREATE TABLE dbo.MemoryOptimizedTable
(
    Id INT NOT NULL PRIMARY KEY NONCLUSTERED HASH WITH (BUCKET_COUNT = 1000000),
    Col1 NVARCHAR(100) NOT NULL,
    Col2 DATETIME NOT NULL
) WITH (MEMORY_OPTIMIZED = ON, DURABILITY = SCHEMA_AND_DATA);
GO
SELECT * FROM dbo.MemoryOptimizedTable
WITH (SNAPSHOT); -- 或設定 SESSION 隔離等級為 SNAPSHOT
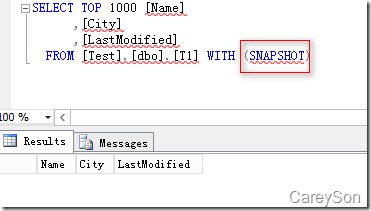
注意:Hash Index
BUCKET_COUNT為固定值,不支援動態擴展,建議設為預估最大列數 1~2 倍,避免桶衝突導致效能劣化。
| 功能 | 支援狀態 |
|---|---|
| AlwaysOn 可用性群組 | ✅ 完整支援 |
| 記錄傳送 / 備份還原 | ✅ 完整支援 |
| 資料庫鏡像 | ❌ 不支援 |
| 交易式複寫 | ❌ 不支援 |
| 外鍵/檢查條件約束/觸發器 | ❌ 不支援 |
| 跨資料庫查詢/分散式交易 | ❌ 不支援 |
測試案例:高並發插入/更新負載
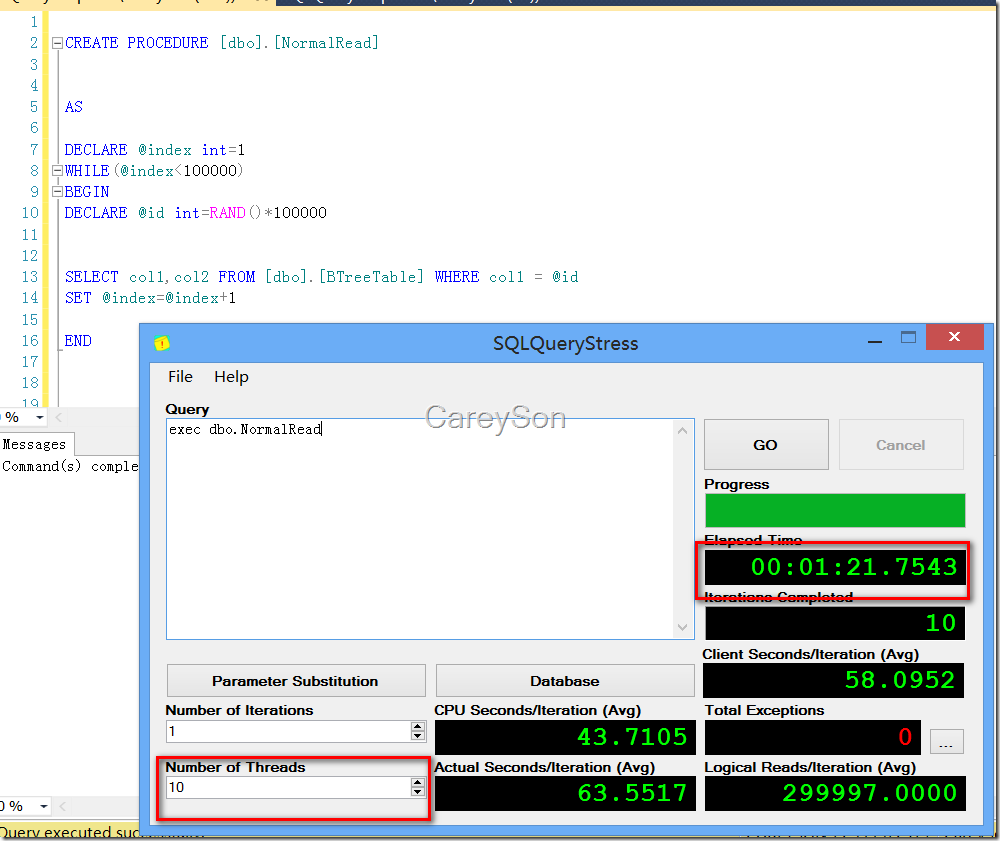
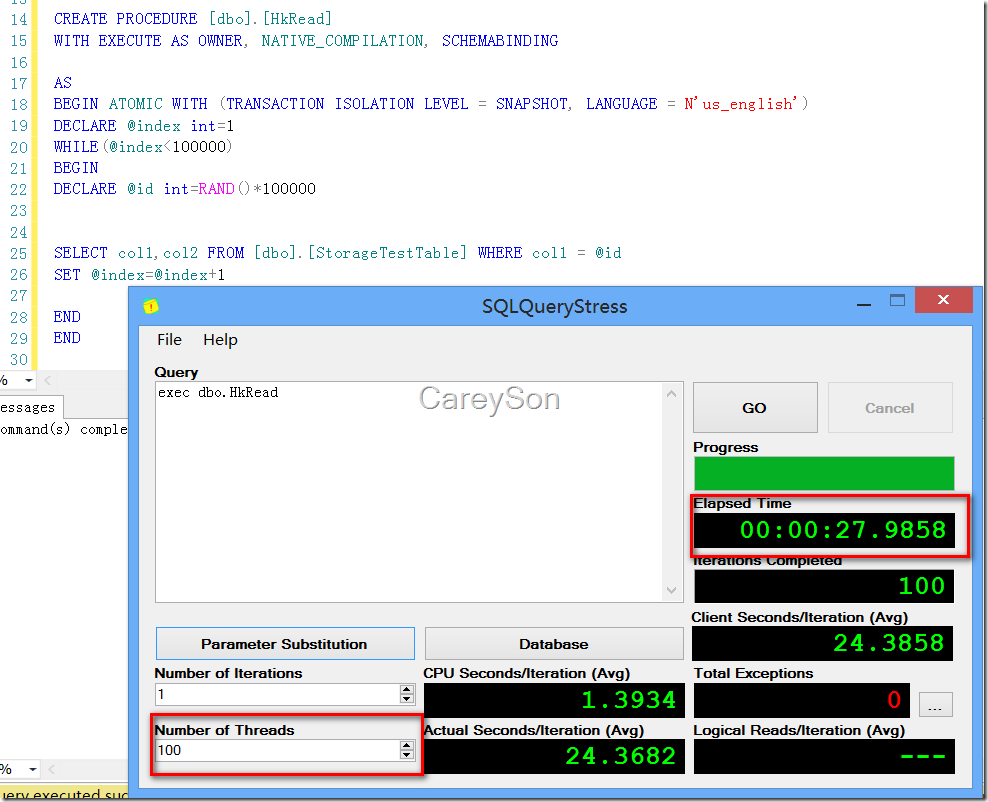
結果:Hekaton 組合在相同硬體下達成接近數十倍的吞吐量提升,CPU 使用率更低、延遲更穩定。
Hekaton 不是單純「把表放記憶體」,而是從資料結構、並發控制、程式碼執行三個維度重新設計。雖 2014 版有諸多限制,但為高頻交易、交易核心、即時分析等核心場景帶來了質變級效能突破。後續版本 (2016/2017/2019) 持續擴展相容性,已成企業級高效能架構標配。