首頁
編程語言
C語言|JAVA編程
Python編程
網頁編程
ASP編程|PHP編程
JSP編程
數據庫
MYSQL數據庫|SqlServer數據庫
Oracle數據庫|DB2數據庫
您现在的位置: 程式碼之家 >> 數據庫知識 >  >> SQL Server 資料庫 >> 關於SqlServer

SQL Server 快速隨機取樣:ORDER BY NEWID() 技巧與原理解析

     編輯:關於SqlServer

需要從資料表隨機抽取資料列?SQL Server 提供極簡單且強大的單行語法:

SELECT * FROM Person.Person ORDER BY NEWID();

運作原理

  1. NEWID() 為每列產生唯一的 UNIQUEIDENTIFIER 值。
  2. 查詢最佳化器在該虛擬欄位上執行**實體排序**操作(Sort 運算子)。
  3. 因 ORDER BY 邏輯發生在 SELECT 列表投射**之後**,NEWID() 欄位本身**不會**出現在最終結果集中。
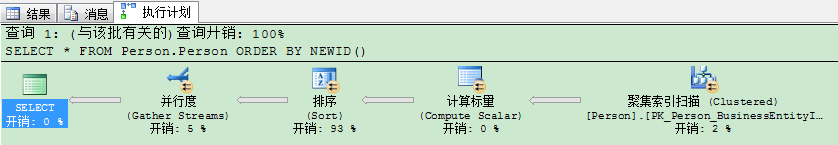
執行計畫顯示 Sort 運算子

效能考量與替代方案

  • 優點:語法簡潔、邏輯正確、無需額外物件。
  • 缺點:全表掃描 + 排序,複雜度 O(N log N),大資料集極慢、佔用 tempdb。
  • 大表替代方案:
    • TABLESAMPLE (n PERCENT/ROWS):頁面層級抽樣,極快但非真隨機、可能回傳 0 列。
    • WHERE RAND(CHECKSUM(*) * NEWID()) < 0.01:Bernoulli 抽樣,單次掃描無排序,近似隨機。
    • 預先建立隨機排序鍵欄位(如 RAND() 或 NEWID() 定期更新),查詢時直接 ORDER BY RandomKey。

適用場景建議

  • 小/中型表(< 10 萬列)、臨機分析、測試資料抽樣:ORDER BY NEWID() 完美適用。
  • 大型表、高頻呼叫、生產關鍵路徑:改用 TABLESAMPLE 或預計算隨機鍵。

總結

ORDER BY NEWID() 是 SQL Server 內建最直觀的隨機取樣寫法,理解其「全表排序」本質,依資料量與 SLA 選擇最適策略。

  1. 上一篇文章:
  2. 下一篇文章:
Copyright © 程式碼之家 All Rights Reserved