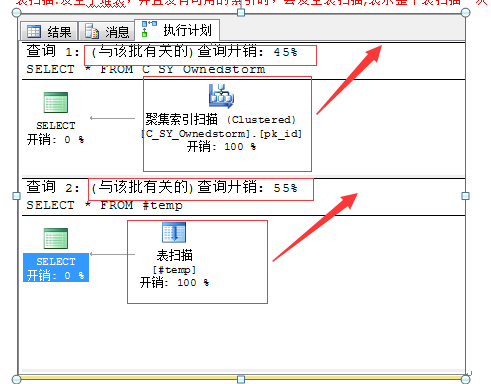
發生於擁有叢集索引的資料表,相當於全表掃描,但在針對叢集索引鍵條件查詢時效能較佳。
SELECT * FROM C_SY_Ownedstorm
發生於堆積表(無叢集索引)且無可用索引時,需完整掃描整張表。
SELECT * FROM #temp
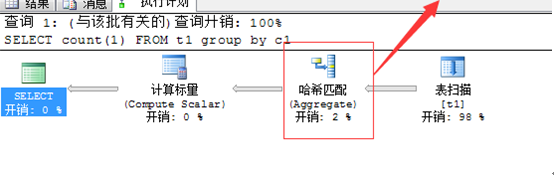
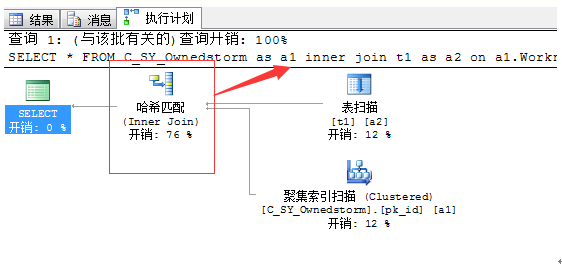
將較小的資料集建立雜湊表,再由較大資料集進行探測匹配。出現雜湊匹配通常暗示:
優化策略:檢查是否可透過加入適當索引或縮減資料量來改用巢狀迴圈或合併連接。
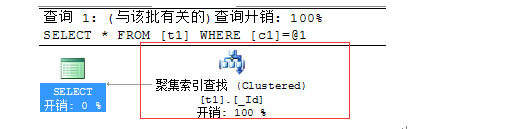
最理想的存取路徑,透過索引鍵直接定位資料。
CREATE UNIQUE CLUSTERED INDEX _Id ON t1(c1);
SELECT * FROM t1 WHERE c1 = 3;
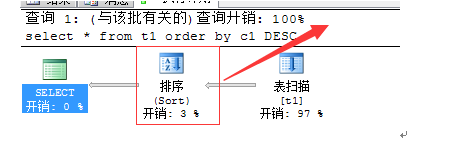
SQL Server 在取得資料後才進行排序,消耗 CPU 與記憶體。可透過索引排序順序避免額外排序。
SELECT * FROM t1 ORDER BY c1 DESC;
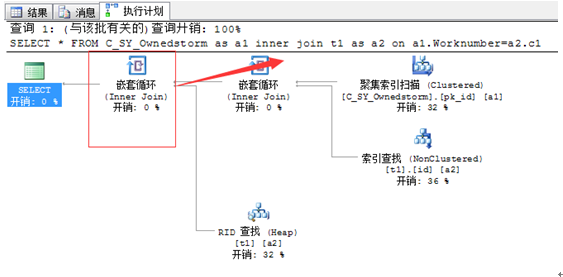
適用於小資料量表且連接欄位有索引的情況。外部表逐行迴圈,內部表索引查找匹配行。I/O 與比較次數最少。
要求兩輸入集合已排序。單掃描即可完成連接,總成本與輸入行數總和成正比,適合大量資料連接。
CREATE TABLE t1(c1 INT, c2 VARCHAR(8000));
GO
DECLARE @a INT = 1;
WHILE (@a <= 5000)
BEGIN
    INSERT INTO t1 VALUES (@a, REPLICATE('a', 5000));
    SET @a = @a + 1;
END
GO
SELECT COUNT(1) FROM t1 GROUP BY c1;