Index Seek (索引查尋) 為高效點查/範圍查;Index Scan (索引掃描) 為全索引掃描。執行計劃從 Seek 退化為 Scan,通常意味著**優化器無法利用索引定位**,被迫掃描大量頁面。本文系統梳理 5 大核心原因、驗證腳本與避坑指南。
欄位 NationalIDNumber NVARCHAR(15),查詢條件傳入數值 112457891:
SELECT NationalIDNumber, LoginID
FROM HumanResources.Employee
WHERE NationalIDNumber = 112457891; -- 隱式轉換:欄位被轉為數值比較
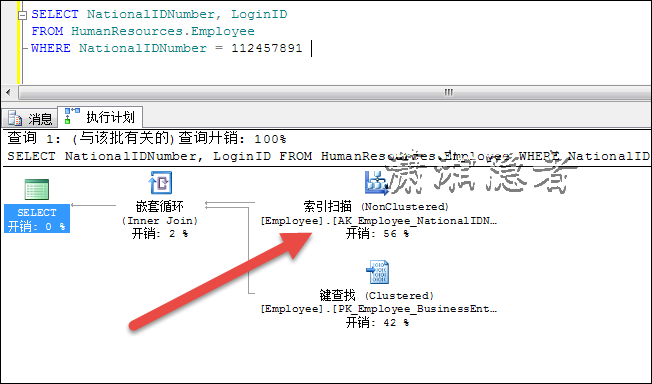
計劃顯示 CONVERT_IMPLICIT(int, [NationalIDNumber], 0),**欄位端參與運算 → 索引失效**。
WHERE NationalIDNumber = N'112457891'; -- 字串常數,型別匹配,Seek 生效
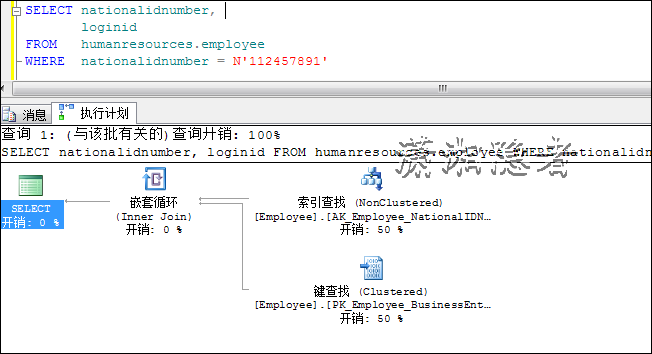
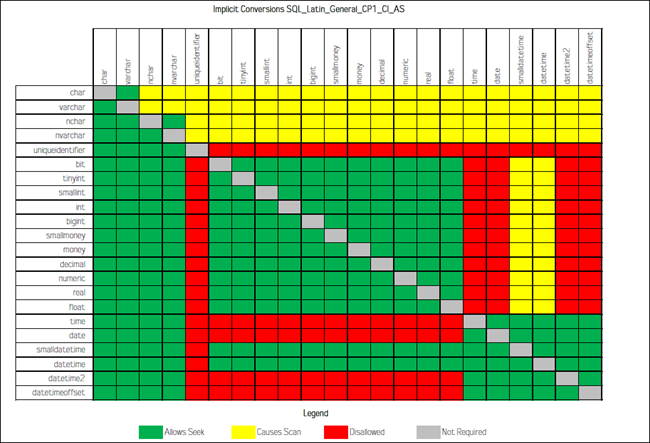
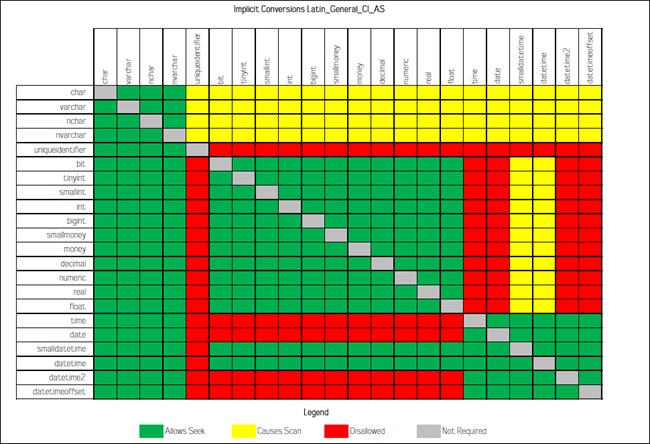
核心規則:**字串比較數值、日期比較字串、高精度比較低精度** 等導致欄位端轉換時,索引失效。
CONVERT_IMPLICIT:SET TRANSACTION ISOLATION LEVEL READ UNCOMMITTED;
DECLARE @db SYSNAME = QUOTENAME(DB_NAME());
WITH XMLNAMESPACES (DEFAULT 'https://schemas.microsoft.com/sqlserver/2004/07/showplan')
SELECT
stmt.value('(@StatementText)[1]', 'varchar(max)') AS QueryText,
t.value('(ScalarOperator/Identifier/ColumnReference/@Schema)[1]', 'varchar(128)') AS SchemaName,
t.value('(ScalarOperator/Identifier/ColumnReference/@Table)[1]', 'varchar(128)') AS TableName,
t.value('(ScalarOperator/Identifier/ColumnReference/@Column)[1]', 'varchar(128)') AS ColumnName,
ic.DATA_TYPE AS ConvertFrom, t.value('(@DataType)[1]', 'varchar(128)') AS ConvertTo,
query_plan
FROM sys.dm_exec_cached_plans cp
CROSS APPLY sys.dm_exec_query_plan(cp.plan_handle) qp
CROSS APPLY qp.query_plan.nodes('/ShowPlanXML/BatchSequence/Batch/Statements/StmtSimple') batch(stmt)
CROSS APPLY stmt.nodes('.//Convert[@Implicit="1"]') n(t)
JOIN INFORMATION_SCHEMA.COLUMNS ic
ON QUOTENAME(ic.TABLE_SCHEMA) = t.value('(ScalarOperator/Identifier/ColumnReference/@Schema)[1]', 'varchar(128)')
AND QUOTENAME(ic.TABLE_NAME) = t.value('(ScalarOperator/Identifier/ColumnReference/@Table)[1]', 'varchar(128)')
AND ic.COLUMN_NAME = t.value('(ScalarOperator/Identifier/ColumnReference/@Column)[1]', 'varchar(128)')
WHERE t.exist('ScalarOperator/Identifier/ColumnReference[@Database=sql:variable("@db")][@Schema!="[sys]"]') = 1;
SARG (Search Argument) = 可用索引查尋的謂詞形式:Column OP Constant (OP = =, >, <, >=, <=, BETWEEN, IN, LIKE 'prefix%')。
WHERE SUBSTRING(NationalIDNumber, 1, 3) = '112'; -- 掃描
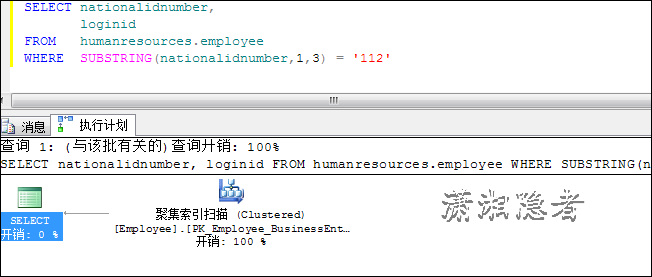
改寫:WHERE NationalIDNumber LIKE '112%' (Seek)。
WHERE BusinessEntityID + 10 < 260; -- 掃描
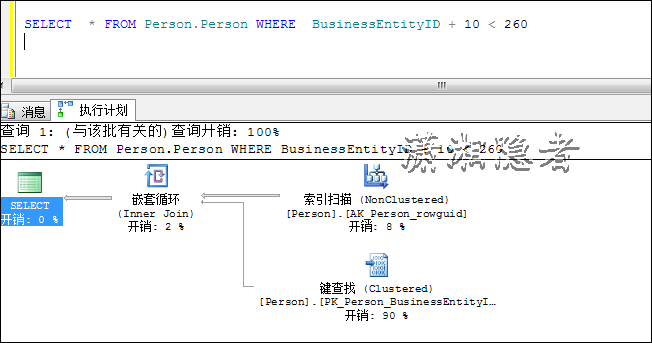
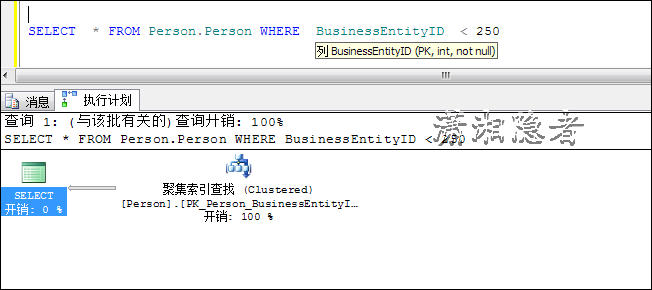
改寫:WHERE BusinessEntityID < 250 (Seek)。
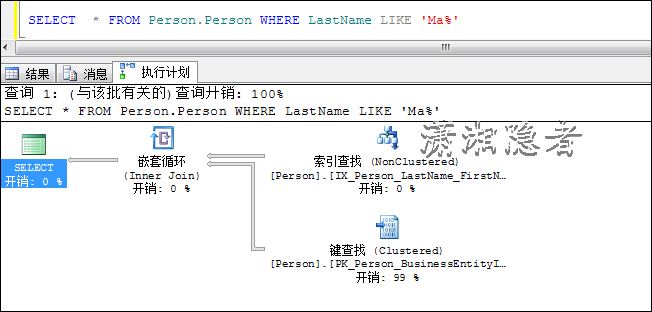
WHERE LastName LIKE 'Ma%';   -- Seek (前綴)
WHERE LastName LIKE '%Ma%';  -- Scan (含前導 %)
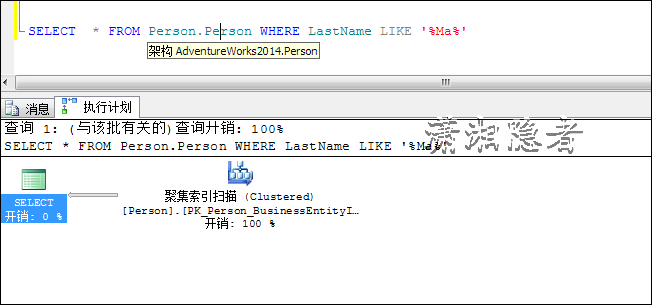
NOT IN, NOT EXISTS, <>, !=, !>, !< 通常導致 Scan (優化器難以利用索引定位「非」集合)。
定義:非叢集非覆蓋索引,若預估回表行數超過 **「臨界點」**,優化器改為 **叢集索引掃描/表掃描**,避免大量隨機 I/O (Key Lookup/Bookmark Lookup)。
DROP TABLE IF EXISTS dbo.TestTipping;
CREATE TABLE dbo.TestTipping (ObjectID INT, Name VARCHAR(8));
CREATE INDEX IX_TestTipping_ObjectID ON dbo.TestTipping(ObjectID);
INSERT dbo.TestTipping SELECT TOP 10000 ROW_NUMBER() OVER (ORDER BY (SELECT NULL)), 'kerry' FROM sys.objects a, sys.objects b;
UPDATE STATISTICS dbo.TestTipping WITH FULLSCAN;

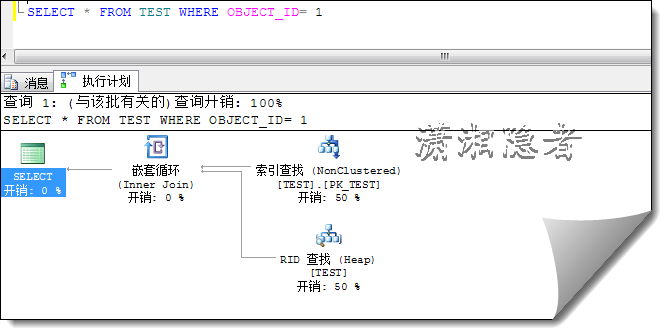
-- 1. 高選擇性 (1 行) -> Seek + Key Lookup
SELECT * FROM dbo.TestTipping WHERE ObjectID = 1;
-- 圖: Index Seek -> Key Lookup
-- 2. 更新 2001 行 ObjectID=1 (佔總 10000 行 的 20%)
UPDATE dbo.TestTipping SET ObjectID = 1 WHERE ObjectID <= 2000;
UPDATE STATISTICS dbo.TestTipping WITH FULLSCAN;

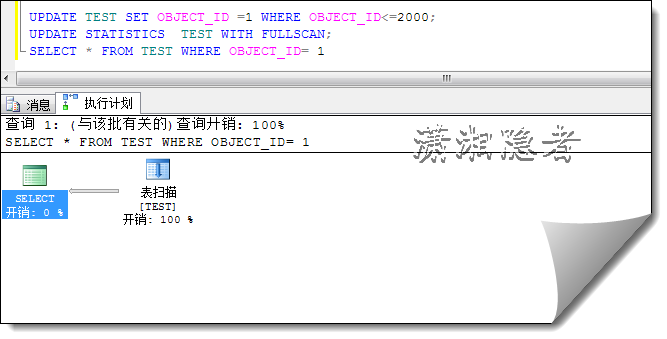
-- 3. 再次查詢 ObjectID=1 -> Table Scan (臨界點約 20-30%)
SELECT * FROM dbo.TestTipping WHERE ObjectID = 1;
-- 圖: Table Scan
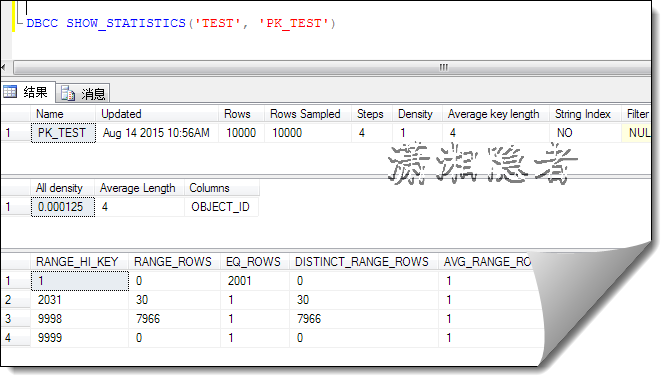
INCLUDE → 變為覆蓋索引 → 強制 Seek。統計資訊是優化器估算基數 (行數) 的唯一依據。缺失/過時 → 估算嚴重偏離實際 → 選錯計劃 (Seek ↔ Scan)。
AUTO_CREATE_STATISTICS ON、AUTO_UPDATE_STATISTICS ON (預設開啟)。UPDATE STATISTICS ... WITH FULLSCAN 定期維護 (維護窗口)。DBCC SHOW_STATISTICS 檢查直方圖/密度向量。索引 (SalesOrderID, SalesOrderDetailID):
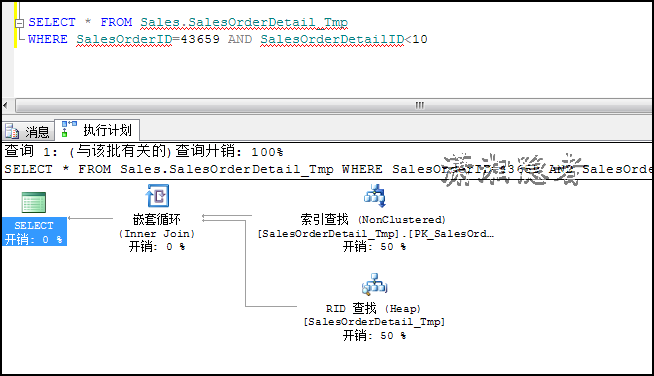
-- 1. 條件含前導欄位 -> Seek
SELECT * FROM Sales.SalesOrderDetail_Tmp
WHERE SalesOrderID = 43659 AND SalesOrderDetailID < 10;
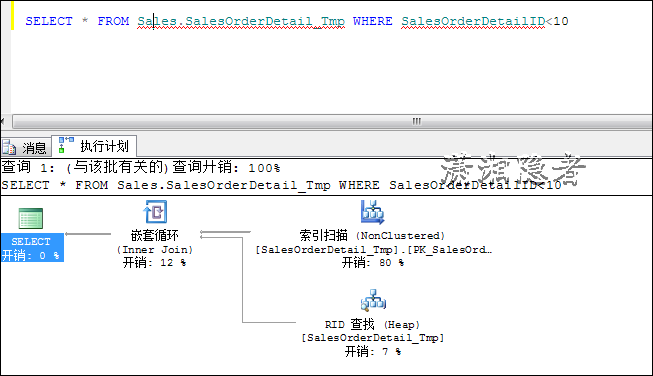
-- 2. 條件僅含第二欄位 -> Scan (無法 Seek)
SELECT * FROM Sales.SalesOrderDetail_Tmp
WHERE SalesOrderDetailID < 10;
鐵律:複合索引 **僅當 WHERE/JOIN 條件包含最左前導欄位 (可為範圍) 時才能 Seek**。單獨查詢非前導欄位需另建單欄索引。
| # | 原因 | 核心機制 | 解決關鍵 |
|---|---|---|---|
| 1 | 隱式轉換 | 欄位端 CONVERT_IMPLICIT 破壞索引鍵順序 | 常數/參數型別與欄位嚴格一致 |
| 2 | 非 SARGable | 函數/運算/前導%/否定 破壞索引定位能力 | 改寫為 Column OP Constant 形式 |
| 3 | 臨界點 | 非覆蓋索引回表成本 > 全掃描成本 | 建立覆蓋索引 (INCLUDE 查詢欄位) |
| 4 | 統計失真 | 基數估算錯誤誤導成本模型 | 全掃描更新統計、啟用自動更新 |
| 5 | 複合索引順序 | 非前導欄位無法定位 B-Tree | 調整索引欄位順序或新建單欄索引 |
**排查口訣**:看計劃找 CONVERT_IMPLICIT/Scan → 檢查型別/寫法 → 看統計/選擇性 → 看索引定義/覆蓋 → 改寫/加索引/更新統計。