資料庫健康檢查發現 SQL Server Idle 時間驟降,I/O 尚有餘力,推測為高 CPU 查詢語句導致。
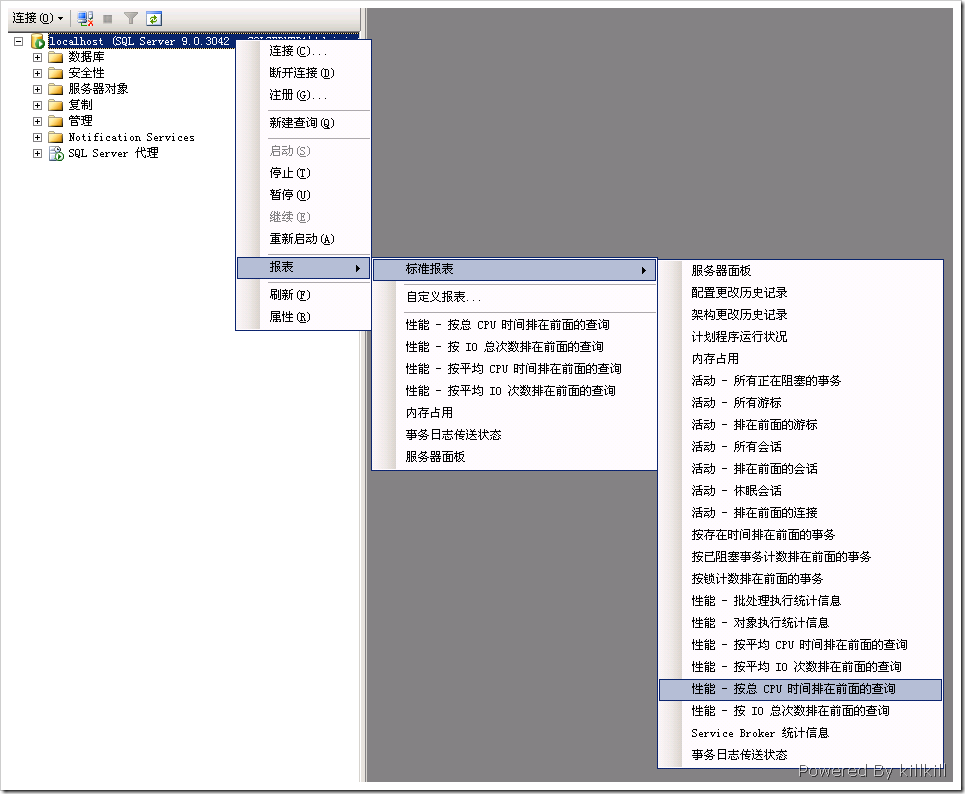
使用 SQL Server 內建 效能儀表板報表 →「依總 CPU 時間排序的前 N 條查詢」。
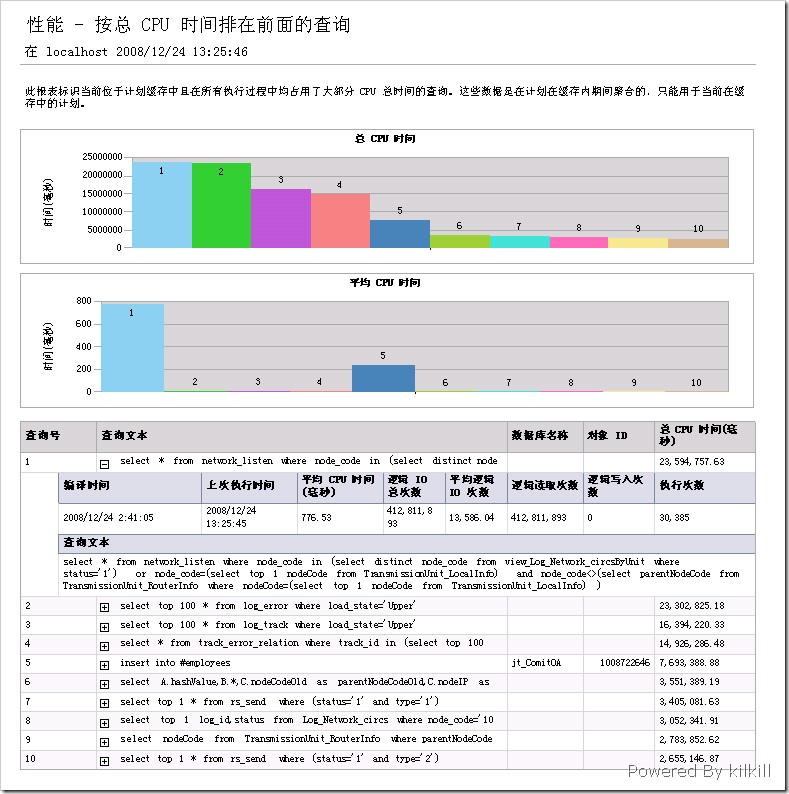
報表無法直接複製 SQL、不明確標示所屬資料庫,需另存 Excel 再手動比對,耗時較久。最終在非生產環境還原該資料庫進行實測。
SELECT *
FROM network_listen
WHERE node_code IN (
    SELECT DISTINCT node_code
    FROM view_Log_Network_circsByUnit
    WHERE status = '1'
)
OR node_code = (
    SELECT TOP 1 nodeCode
    FROM TransmissionUnit_LocalInfo
)
AND node_code <> (
    SELECT parentNodeCode
    FROM TransmissionUnit_RouterInfo
    WHERE nodeCode = (
        SELECT TOP 1 nodeCode
        FROM TransmissionUnit_LocalInfo
    )
);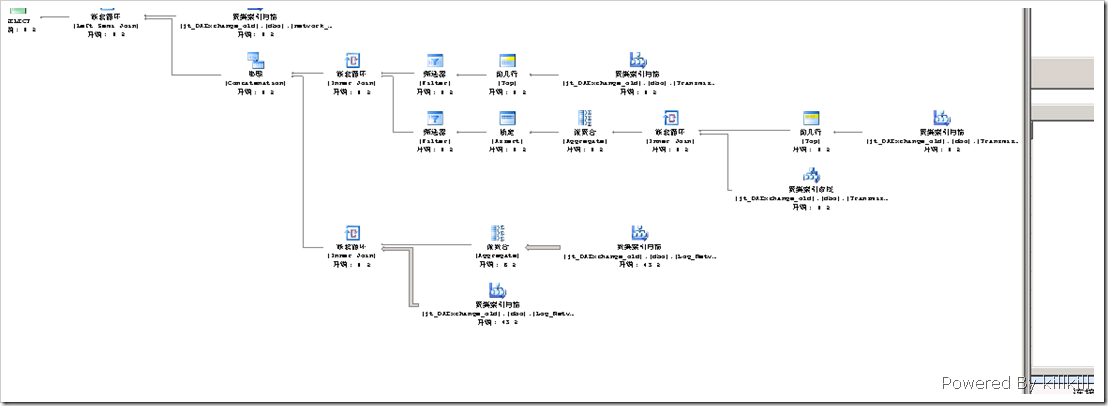
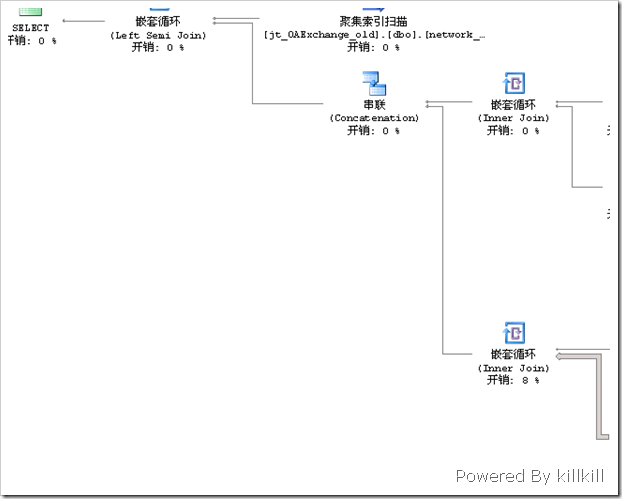
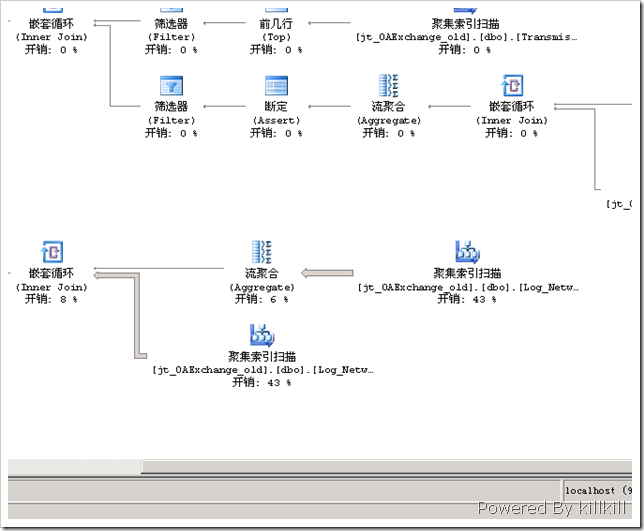
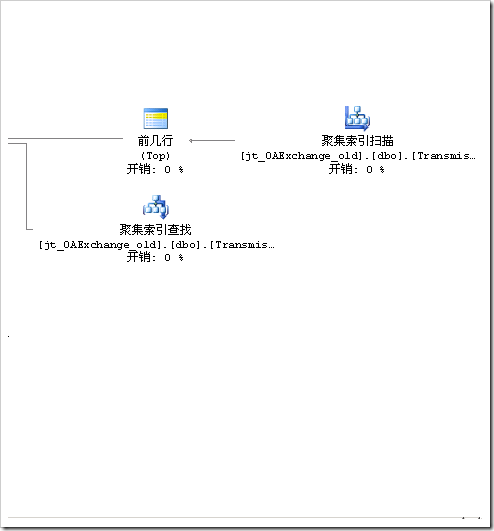
主要成本集中在兩個 Clustered Index Scan(叢集索引掃描),對應資料表 Log_Network_circs。原查詢並未直接參考此表,推測為視圖 view_Log_Network_circsByUnit 導致。
CREATE VIEW [dbo].[view_Log_Network_circsByUnit] AS
SELECT B.*
FROM (
    SELECT node_code, MAX(end_time) AS end_time
    FROM Log_Network_circs
    GROUP BY node_code
) A
LEFT OUTER JOIN dbo.Log_Network_circs B
ON A.node_code = B.node_code AND A.end_time = B.end_time;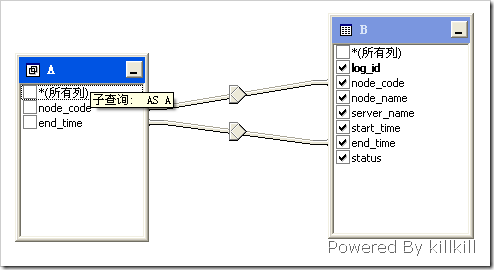
無法修改應用 SQL,僅能調整視圖底層物件。觀察 Log_Network_circs 結構:
CREATE TABLE [dbo].[Log_Network_circs](
    [log_id] [varchar](30) NOT NULL,
    [node_code] [varchar](100) NULL,
    [node_name] [varchar](100) NULL,
    [server_name] [varchar](100) NULL,
    [start_time] [datetime] NULL,
    [end_time] [datetime] NULL,
    [status] [varchar](30) NULL,
    CONSTRAINT [PK_LOG_NETWORK_CIRCS] PRIMARY KEY CLUSTERED ([log_id] ASC)
) ON [PRIMARY];
資料量約 49 萬筆。依據「常用於 JOIN 的欄位建立索引」原則,在 (node_code, end_time) 建立複合非叢集索引。
使用 資料庫引擎調優顧問 分析,建議建立統計資料與索引:
CREATE STATISTICS [_dta_stat_559341057_6_2] ON [dbo].[Log_Network_circs]([end_time], [node_code]);

CREATE NONCLUSTERED INDEX [_dta_index_Log_Network_circs_24_559341057__K2_K6]
ON [dbo].[Log_Network_circs]([node_code] ASC, [end_time] ASC)
WITH (SORT_IN_TEMPDB = OFF, IGNORE_DUP_KEY = OFF, DROP_EXISTING = OFF, ONLINE = OFF) ON [PRIMARY];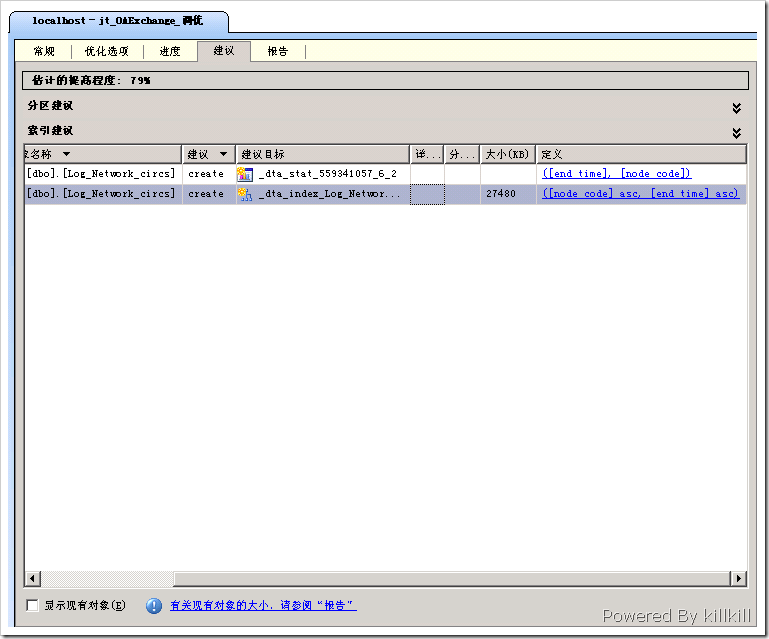
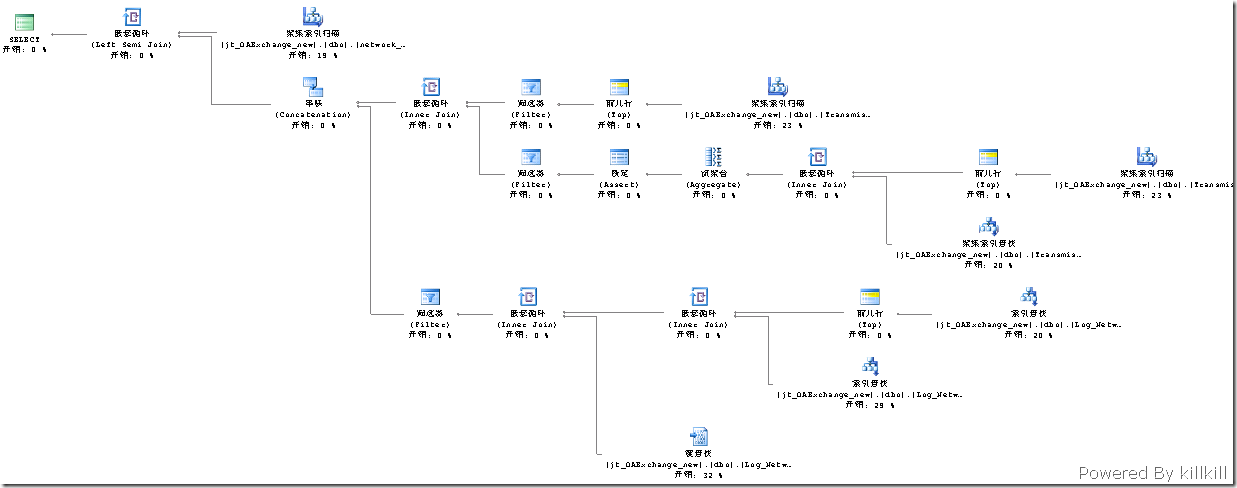
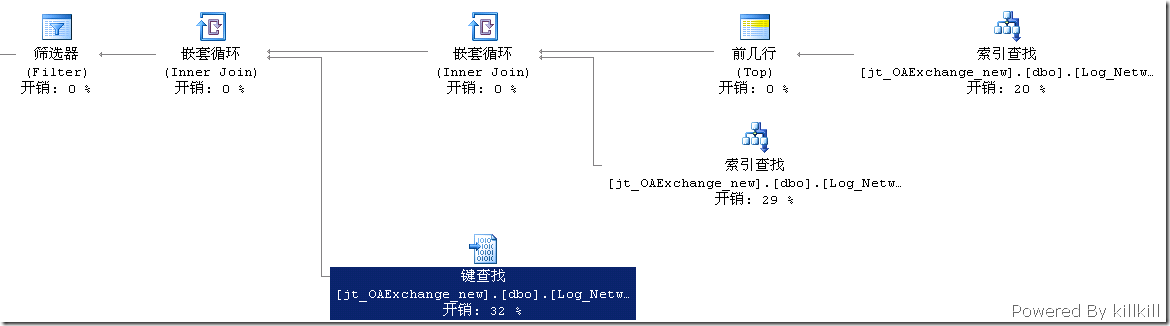
啟用統計資訊:
SET STATISTICS IO ON;
SET STATISTICS TIME ON;
結果: Log_Network_circs 邏輯讀取從掃描全表大幅降低,CPU 佔用顯著下降,調優成功。