聚合函數 (SUM, COUNT, AVG, MIN, MAX) 是 OLAP 報表與 OLTP 統計的核心。SQL Server 查詢優化器根據資料分布、索引、記憶體授予動態選擇 **流聚合** 或 **雜湊聚合** 兩種演算法。理解其運作原理、適用場景與優化手段,是編寫高效聚合查詢的關鍵。
環境:SQL Server 2019, Northwind 範例資料庫。
SELECT COUNT(*) FROM dbo.Orders;
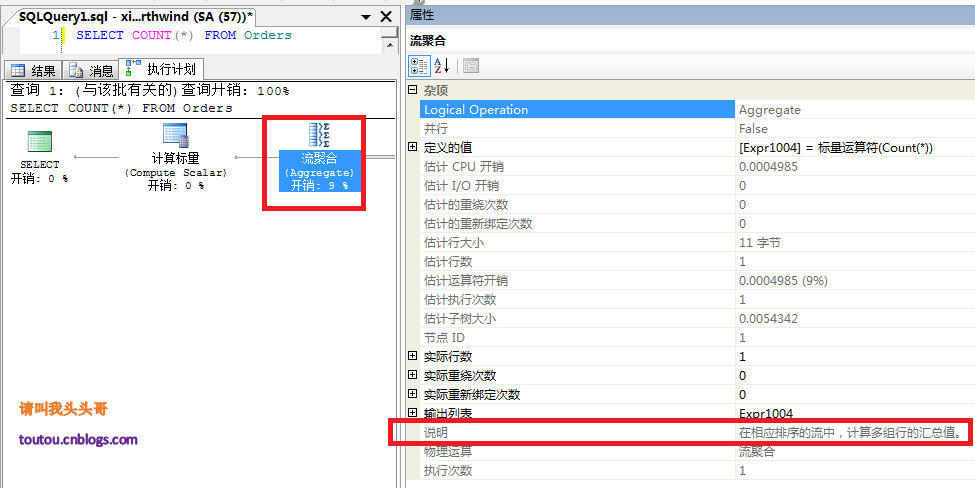
計劃解讀:
bigint 計數轉為 int 輸出。-- 查詢 1:ShipCity 有大量重複值 SELECT COUNT(DISTINCT ShipCity) FROM Orders; -- 查詢 2:OrderID 為主鍵,無重複 SELECT COUNT(DISTINCT OrderID) FROM Orders;
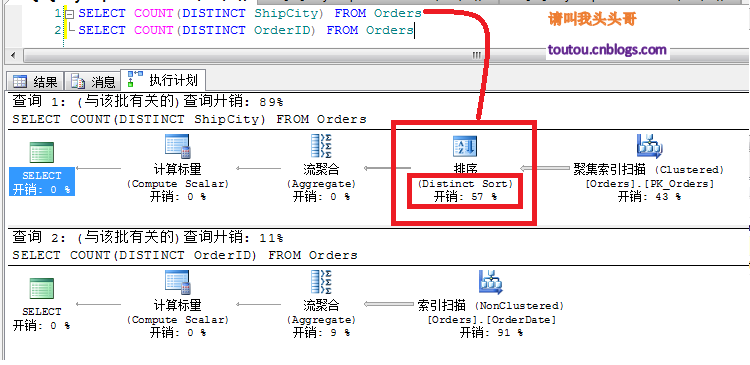
分析:DISTINCT 內部實現為 **Sort -> Stream Aggregate**。ShipCity 重複率高,排序後去重有效;OrderID 唯一,排序純屬浪費。**優化**:「為高基數去重欄位建立索引,避免顯式排序」。
CREATE INDEX IX_Orders_ShipCity ON Orders(ShipCity DESC);
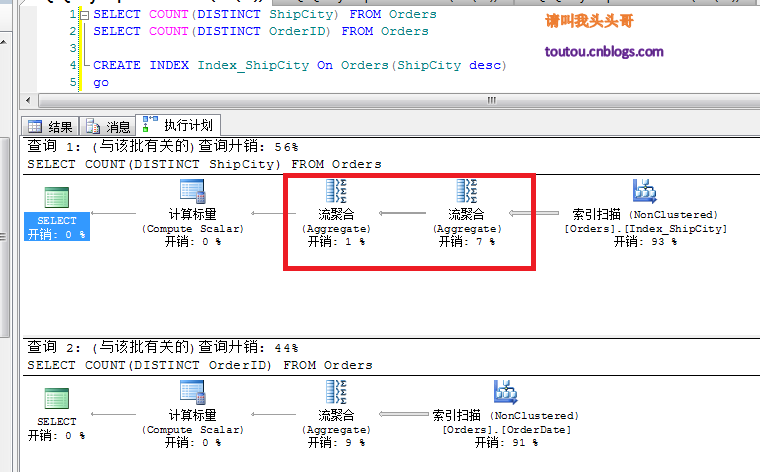
索引提供有序輸入,優化器直接雙流聚合 (第一層去重,第二層計數)、**完全消除 Sort**,成本大幅下降。
-- 低基數群組:ShipCountry (少數幾十國) -> Hash Aggregate
SELECT ShipCountry, COUNT(*) FROM Orders GROUP BY ShipCountry;
-- 高基數群組:CustomerID (數百客戶) -> Stream Aggregate (因有索引順序)
SELECT CustomerID, COUNT(*) FROM Orders GROUP BY CustomerID;
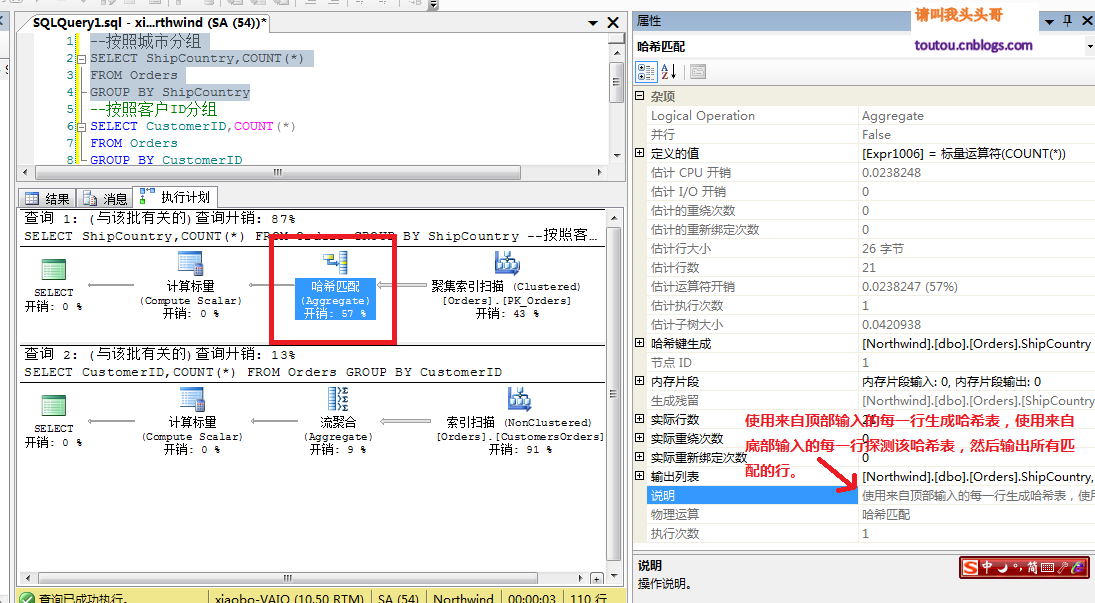
核心洞見:優化器根據 **統計資訊估計群組數 (基數)** 決定演算法。**同樣語法,不同資料分布 → 不同計劃**。優化時必須結合實際資料分布,不能只看 SQL 文本。
INCLUDE 覆蓋索引,使掃描輸出天然有序 → 強制流聚合,零記憶體授予、零 TempDB 壓力。DISTINCT;UNION 改 UNION ALL + 外層去重。APPROX_COUNT_DISTINCT SQL 2019+)。Desired Memory vs Granted Memory,若 Spill 到 TempDB (Warnings 有 SpillToTempDb),需調整 MAX_GRANT_PERCENT 或重寫查詢。UPDATE STATISTICS ... WITH FULLSCAN 確保基數估計準確,避免優化器誤選演算法。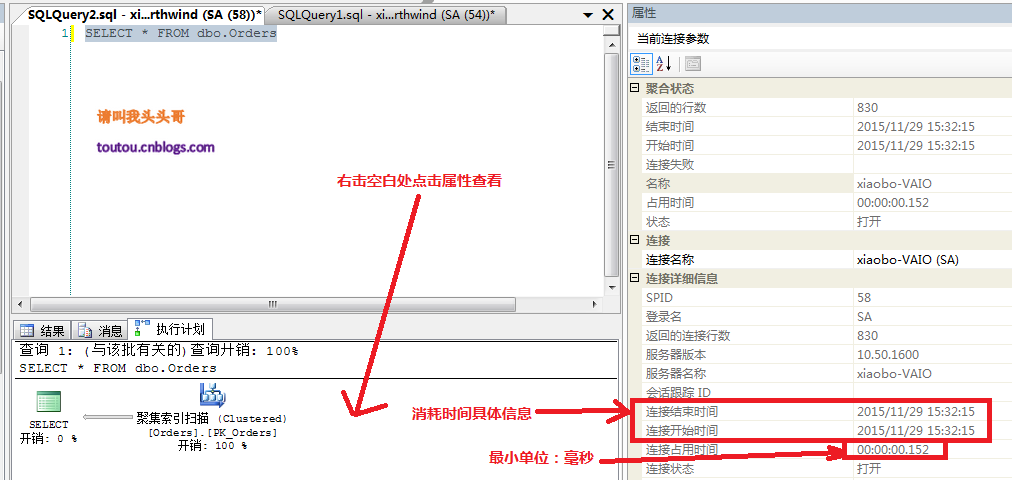
| 指標類別 | 關鍵計數器 / DMV | 健康閾值 / 觀察重點 |
|---|---|---|
| 執行時間 | SET STATISTICS TIME ON / sys.dm_exec_query_stats | CPU Time vs Elapsed Time 差距大 → 等待/阻塞/並行度問題 |
| IO 開銷 | SET STATISTICS IO ON / sys.dm_exec_query_stats (logical_reads) | Logical Reads 高 → 缺索引/掃描過大;Physical Reads 高 → 記憶體壓力/資料未熱 |
| 記憶體授予 | sys.dm_exec_query_memory_grants / PerfMon: Memory Grants Pending | Pending > 0 持續 → 記憶體不足;Granted << Desired → 受限於 Resource Governor/Max Server Memory |
| TempDB 壓力 | PerfMon: TempDB: Version Store Size, Transactions / sys.dm_db_task_space_usage | Hash Spill / Sort Spill 會激增 TempDB 版本存儲與交易數 |
| CPU 使用率 | PerfMon: Processor: % Processor Time (總體/單核) | 持續 > 80% → 查詢優化/增加核心/調整 MAXDOP |
| 鎖/阻塞 | sys.dm_tran_locks, sys.dm_os_wait_stats (LCK_M_*) | 聚合查詢常因 Sch-S/S 鎖等待 DDL/大量更新 |
-- 傳統精確 COUNT DISTINCT (高記憶體、易 Spill)
SELECT COUNT(DISTINCT CustomerID) FROM dbo.Orders;

-- 近似算法 (HyperLogLog),誤差 < 2%,記憶體固定極小
SELECT APPROX_COUNT_DISTINCT(CustomerID) FROM dbo.Orders;
適用場景:儀表板 KPI、即時分析、百萬級基數估算,**不適用**於財務對帳等需精確場景。
SQL Server 聚合優化的本質是 **「讓資料以有序方式流入聚合運算子」**。通過索引覆蓋 GROUP BY 欄位、消除冗餘排序、監控記憶體授予與 TempDB 溢寫、維護精確統計資訊,即可將聚合查詢效能提升數量級。SQL 2019 引入的近似聚合更為超大基數場景提供了新選擇。建議將本文監控指標納入日常巡檢儀表板,做到「有數據、有預警、有優化」。