網路上 SQL 優化資料雜亂無章,本文整理 34 條經實戰驗證的優化鐵律,涵蓋查詢寫法、索引策略、統計資訊、快取機制、資料型別、排序/分組、應用層配合,按影響力從高到低排序,適合 DBA 與開發者建立優化檢核清單。
一、查詢寫法優化 (最高影響力)
- 避免 SELECT *: 明確列出欄位,減少 I/O、網路傳輸、解析開銷。
- WHERE 條件順序: Oracle 由右至左解析,最能過濾資料的條件寫在最後;SQL Server 由優化器決定,但建議將高選擇性條件前置。
- 用 EXISTS 替代 IN: 子查詢結果集大時,EXISTS 可短路,避免子查詢全掃描/排序合併。
- 用 NOT EXISTS 替代 NOT IN: NOT IN 會觸發子查詢全表掃描 + 排序合併,效能最差;改寫為 LEFT JOIN ... WHERE IS NULL 或 NOT EXISTS。
- 避免 HAVING 取代 WHERE: HAVING 在分組後過濾,WHERE 在分組前過濾,能大幅減少中間結果集。
- 減少資料庫往返: 批次處理、合併多條獨立查詢、調大 ARRAYSIZE (建議 200)。
- 使用 DECODE/CASE 避免重複掃描: 單次掃描完成多條件分支統計。
- 刪除重複資料最高效寫法:
DELETE FROM EMP E WHERE E.ROWID > (SELECT MIN(X.ROWID) FROM EMP X WHERE X.EMP_NO = E.EMP_NO);
- 全表清空用 TRUNCATE 替代 DELETE: 最小化 Log、重置高水位、不觸發 Trigger。
- 適時 COMMIT: 釋放 Rollback Segment、鎖、Redo Log Buffer 空間。
二、索引策略 (核心基建)
- 建立索引提升檢索: B-Tree 結構,大表效果顯著;小表全掃描可能更快。
- 索引維護成本: 每次 INSERT/DELETE/UPDATE 額外 4-5 次磁碟 I/O 維護索引;移除無用索引。
- 定期 REBUILD:
ALTER INDEX ... REBUILD 消除碎片、更新統計資訊。
- 複合索引首欄原則: WHERE 必須包含索引第一欄,否則優化器忽略索引。
- 避免索引欄運算/函數:
WHERE SAL*12 > 25000 → WHERE SAL > 25000/12;函數會導致全掃描。
- 避免索引欄 IS NULL/IS NOT NULL: 空值不存入 B-Tree (單欄索引),改用
>=0 等等價條件。
- 用 >= 替代 >:
DEPTNO >= 4 直接定位到 4;> 3 先定位 3 再掃描。
- UNION 替代 OR (索引欄): OR 導致全掃描;UNION 分別走索引再合併 (需兩欄皆有索引)。
- IN 替代 OR (同一欄多值):
WHERE LOC_ID IN (10,20,30) 可走索引範圍掃描。
- UNION ALL 替代 UNION: 無排序去重開銷,但會保留重複列,需業務允許。
三、排序、分組與集合運算
- WHERE 替代 ORDER BY: ORDER BY 需符合嚴格條件才能用索引;WHERE 可直接走索引範圍。
- GROUP BY 前置過濾: 先 WHERE 後 GROUP BY,減少分組運算量。
- 慎用 DISTINCT/UNION/MINUS/INTERSECT/ORDER BY: 觸發昂貴 SORT 操作,至少 1-2 次排序;優化 SORT_AREA_SIZE 或改寫邏輯。
四、資料型別與隱含轉換
- SQL 關鍵字大寫: Oracle 解析時會將小寫轉大寫,大寫省去轉換。
- 避免 Java 字串連接符 +: 使用 StringBuilder 或 PreparedStatement 參數綁定。
- 防止索引欄隱含轉換:
WHERE char_col = 123 會觸發 TO_NUMBER(char_col) 導致索引失效;改用 WHERE char_col = '123' 或顯式 TO_CHAR(123)。
五、統計資訊與執行計劃
- 識別低效 SQL: 查詢
V$SQLAREA 找出低緩衝命中率、高磁碟讀取、高執行次數的語句。
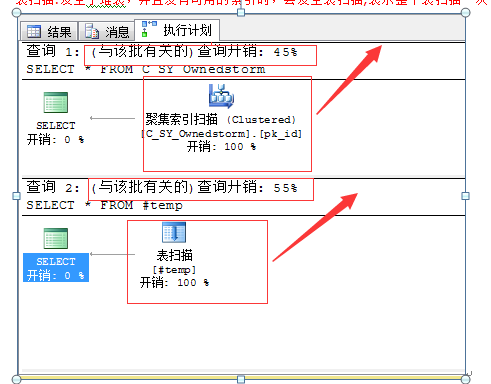
- 30% 門檻: 檢索超過 30% 表資料時,全掃描可能優於索引。
- 索引不總是更快: 特定情況 (資料分布極不均、統計過期) 索引反而比全掃描慢,但數量級差異通常索引快數倍至數千倍。
六、應用層與連線池配合
- 連線池大小: 與 CPU 核心數、並發請求匹配,避免過多連線造成鎖爭用。
- PreparedStatement 重用: 參數化查詢避免硬解析,利用計劃快取。
- Fetch Size 調大: 減少網路往返 (JDBC setFetchSize, OCI 预取)。
- 非同步/批次寫入: 大量匯入用批次 API (Oracle batch, SQL Server SqlBulkCopy)。
七、經典優化查詢腳本
-- 找出緩衝命中率低、磁碟讀取高的 SQL
SELECT EXECUTIONS, DISK_READS, BUFFER_GETS,
       ROUND((BUFFER_GETS-DISK_READS)/BUFFER_GETS,2) Hit_Ratio,
       ROUND(DISK_READS/EXECUTIONS,2) Reads_Per_Run,
       SQL_TEXT
FROM V$SQLAREA
WHERE EXECUTIONS > 0 AND BUFFER_GETS > 0
  AND (BUFFER_GETS-DISK_READS)/BUFFER_GETS < 0.8
ORDER BY 4 DESC;
八、總結:建立優化文化
優化非一次性專案,而是持續過程:
- 監控先行: 建立慢查詢基線、Top SQL 儀表板。
- 規範驅動: 代碼審查強制執行上述鐵律。
- 變更管理: 索引變更、統計收集納入變更流程。
- 知識沉澱: 團隊維護優化案例庫,新人速成。
內化這 34 條鐵律,百萬級資料庫優化將不再是難題,而是標準化的工程實踐。