SQL 敘述句本質是邏輯宣告,而非物理存取路徑。當 T-SQL 送達 SQL Server,查詢處理器依序經歷:解析 → 綁定 → 優化 → 執行。前三階段產出「執行計劃」,最後階段依計劃存取資料。本文聚焦執行計劃生成後的快取機制、儲存物件、效能診斷,以及快取與最佳化器的核心衝突。
編譯執行計劃耗費大量 CPU 與記憶體,主要工作三階段:
同一邏輯查詢可能對應多種物理路徑(如聯結順序),評估所有路徑成本本身即昂貴。因此快取編譯成果、重用計劃成為提升整體吞吐的關鍵。
| 物件類型 | 說明 | 共用特性 |
|---|---|---|
| Compiled Plan (編譯計劃) | 經優化的執行計劃本體,類似 .NET 的 MSIL | 多使用者共用 |
| Execution Context (執行內容) | 執行時的環境狀態:SET 選項、區域變數值等 | 每次執行獨立,關聯同一 Compiled Plan |
| Cursor (游標) | 游標狀態資訊 | 游標專屬連線,但底層計劃可共用 |
| Algebra Tree (代數樹/解析樹) | 查詢文本的樹狀表示,供視圖、預設值、約束重用 | 跨查詢共用,避免重複解析 |
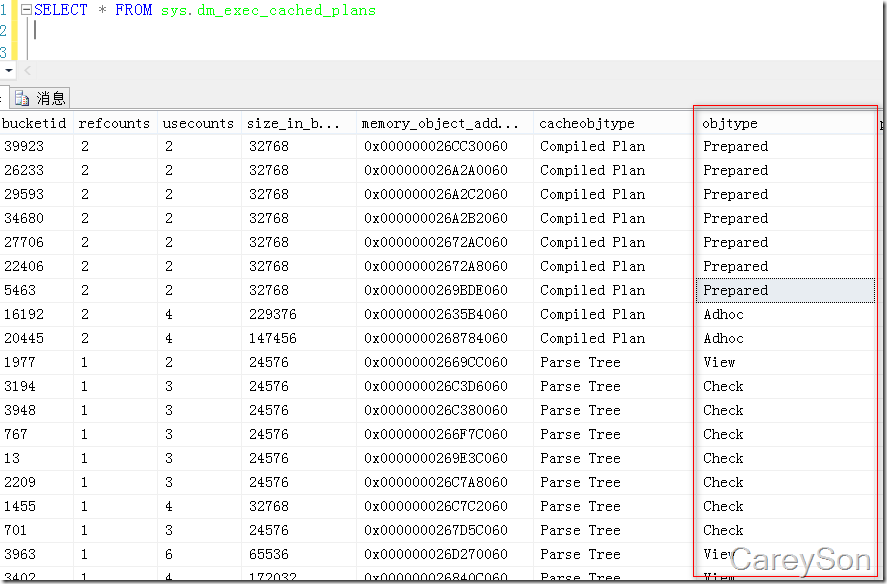
透過 sys.dm_exec_cached_plans 可檢視快取計劃清單:
記憶體佔用細節可查 sys.dm_os_memory_cache_counters:
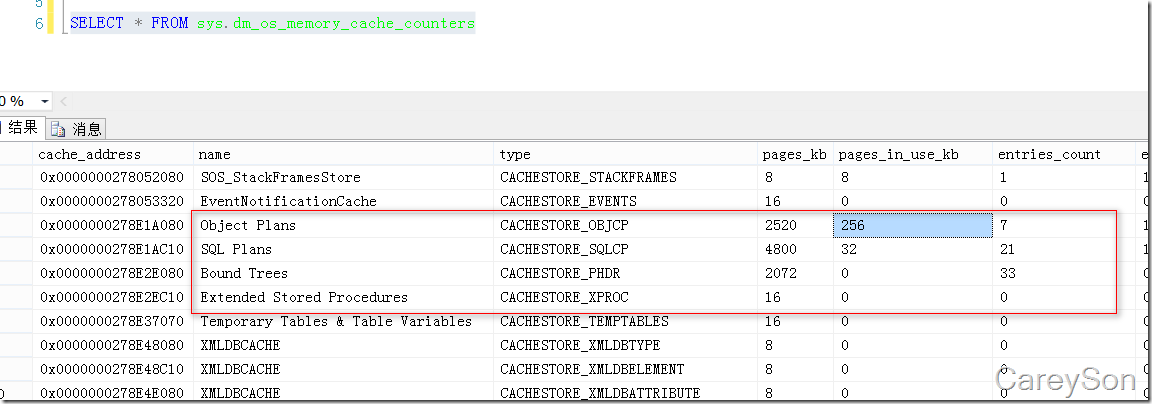
淘汰演算法以記憶體壓力為主導,非單純 LRU。
快取鍵值為查詢文本本身。SELECT * FROM dbo.Table 與 SELECT * FROM Table 會產生兩份計劃。永遠在物件名稱前冠上結構描述名稱,避免不必要的計劃重複。
快取保留豐富統計資訊(CPU、等待時間、執行次數),且不含編譯時間。以下查詢可快速定位實例啟動以來總耗時最長的 20 條查詢:
SET TRANSACTION ISOLATION LEVEL READ UNCOMMITTED;
SELECT TOP 20
    CAST(qs.total_elapsed_time / 1000000.0 AS DECIMAL(28,2)) AS [Total Duration (s)],
    CAST(qs.total_worker_time * 100.0 / qs.total_elapsed_time AS DECIMAL(28,2)) AS [% CPU],
    CAST((qs.total_elapsed_time - qs.total_worker_time) * 100.0 / qs.total_elapsed_time AS DECIMAL(28,2)) AS [% Waiting],
    qs.execution_count,
    CAST(qs.total_elapsed_time / 1000000.0 / qs.execution_count AS DECIMAL(28,2)) AS [Avg Duration (s)],
    SUBSTRING(qt.text, (qs.statement_start_offset/2)+1,
        ((CASE WHEN qs.statement_end_offset = -1
            THEN LEN(CONVERT(NVARCHAR(MAX), qt.text)) * 2
            ELSE qs.statement_end_offset END - qs.statement_start_offset)/2) + 1) AS [Individual Query],
    qt.text AS [Parent Query],
    DB_NAME(qt.dbid) AS DatabaseName,
    qp.query_plan
FROM sys.dm_exec_query_stats qs
CROSS APPLY sys.dm_exec_sql_text(qs.sql_handle) qt
CROSS APPLY sys.dm_exec_query_plan(qs.plan_handle) qp
WHERE qs.total_elapsed_time > 0
ORDER BY qs.total_elapsed_time DESC;
優於 Trace/Profiler:零額外負擔、即時可查。但有盲點:索引重建、統計更新不快取;快取隨時被淘汰;無法累計未參數化同邏輯查詢的統計。
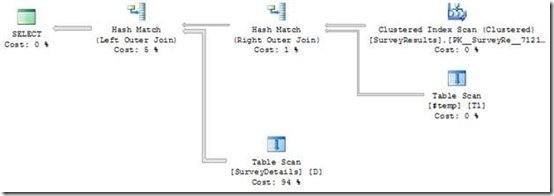
最佳化器依統計資訊為特定參數值生成最優計劃(如小範圍用 Index Seek,大範圍用 Index Scan)。但快取機制將首次編譯計劃重用於後續所有參數值。
經典災難案例:
@TerritoryID = 4(少量資料)執行 → 快存 Index Seek 計劃。@TerritoryID = 5(大量資料)執行 → 強制重用 Index Seek → 執行 5000+ 次 Key Lookup,效能崩潰。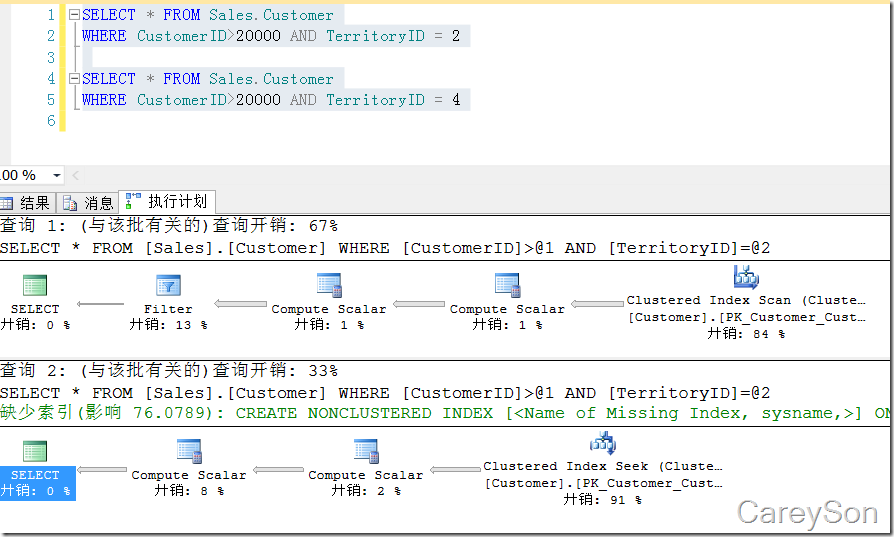
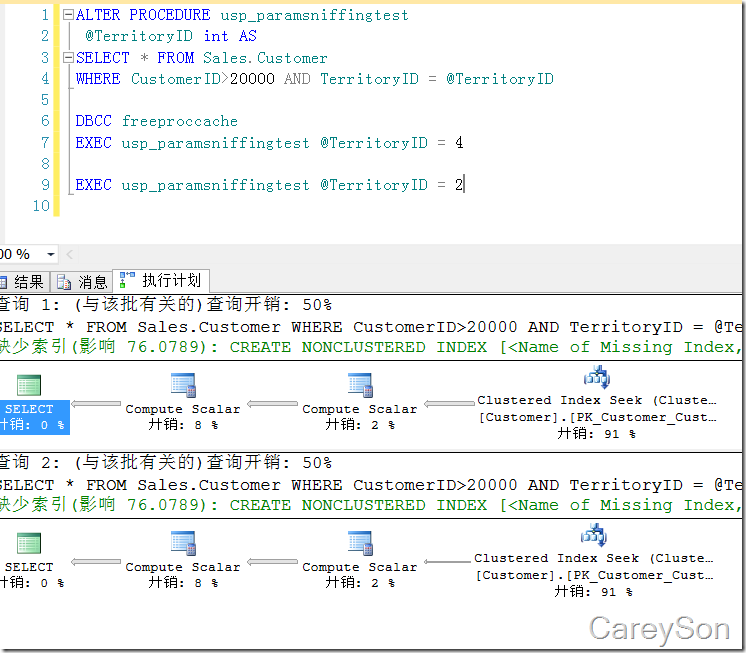
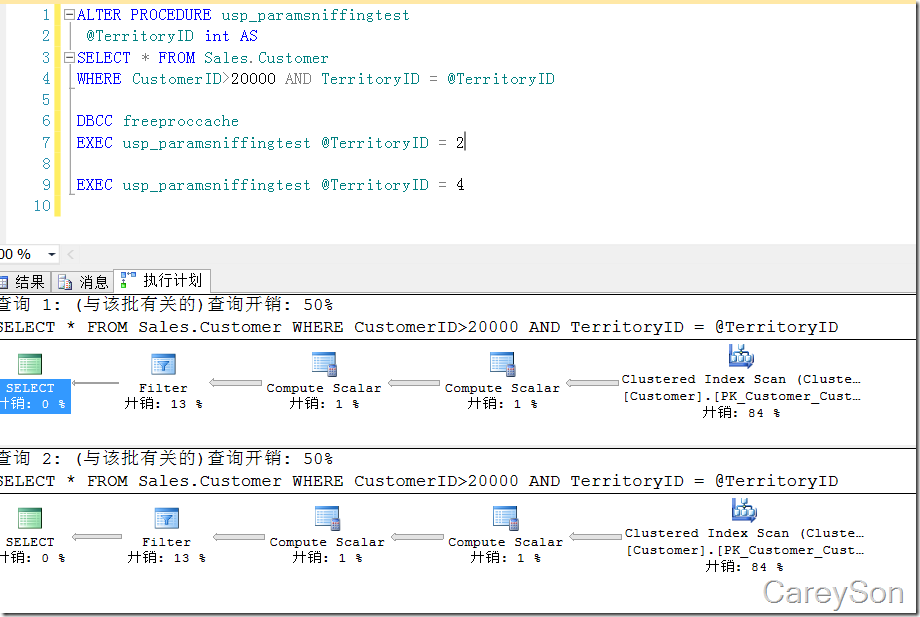
這就是「最佳化器想要精準」與「快取想要重用」的根本衝突。下篇將詳細探討解決方案。