承接上篇「執行計劃快取機制與查詢最佳化器的博弈」,本文聚焦實務中常見的快取膨脹、參數嗅探副作用、計劃重複等問題,並提供從參數化控制、重編譯提示、計劃指南到查詢優化提示的完整解決工具箱。
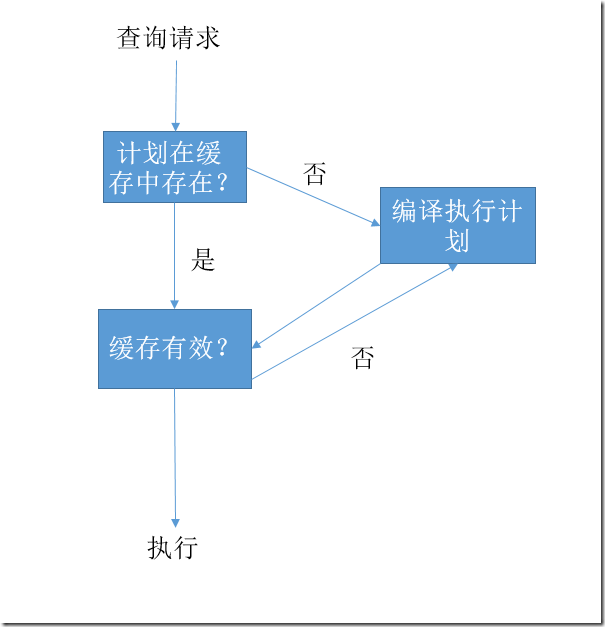
執行計劃快取採用雜湊表結構儲存,查找過程如下:
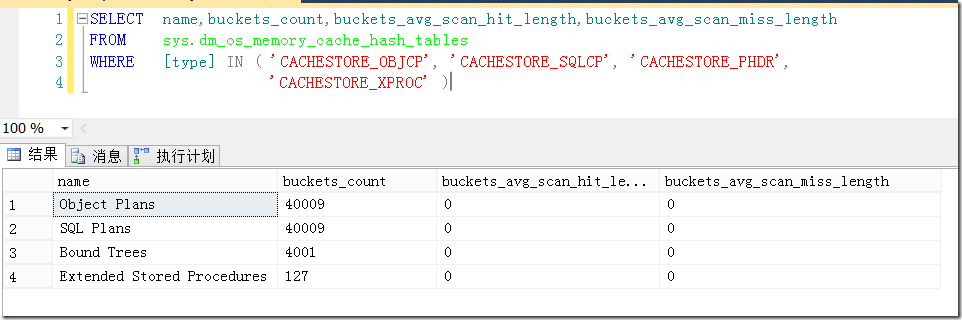
透過 sys.dm_os_memory_cache_hash_tables 可觀察雜湊桶分佈。當大量計劃擠入同一 Bucket 導致鏈表過長,查找效能會驟降。關鍵指標 buckets_avg_scan_miss_length 數值偏高時,即表示發生雜湊碰撞嚴重,需減少快取計劃數量。
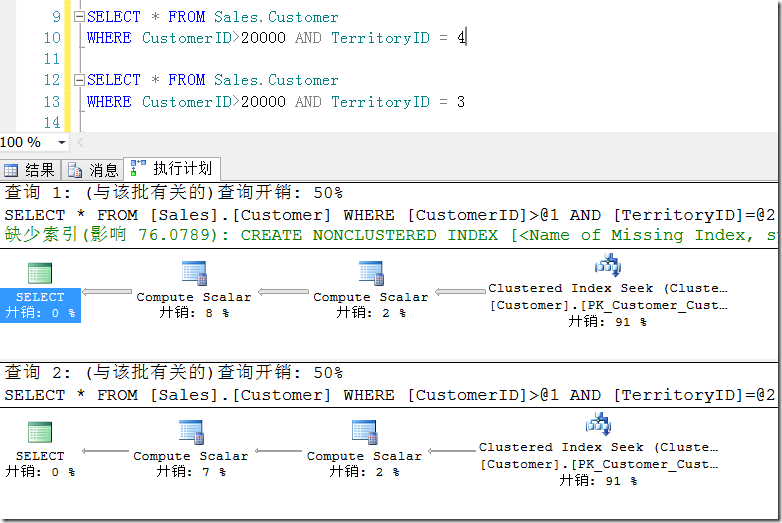
兩條僅 WHERE 子句字面值不同的查詢(如 TerritoryID = 4 vs TerritoryID = 5),雖邏輯相同、最佳化器產出相同計劃,但快取視為不同查詢而產生兩份計劃。
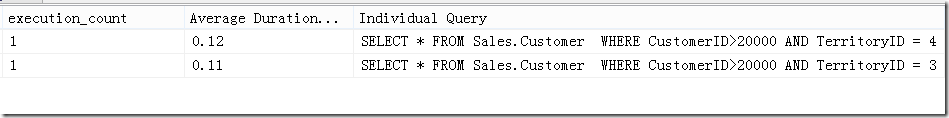
於資料庫層級啟用 FORCED PARAMETERIZATION,可將字面值自動參數化,使快取鍵值一致,達成計劃重用。
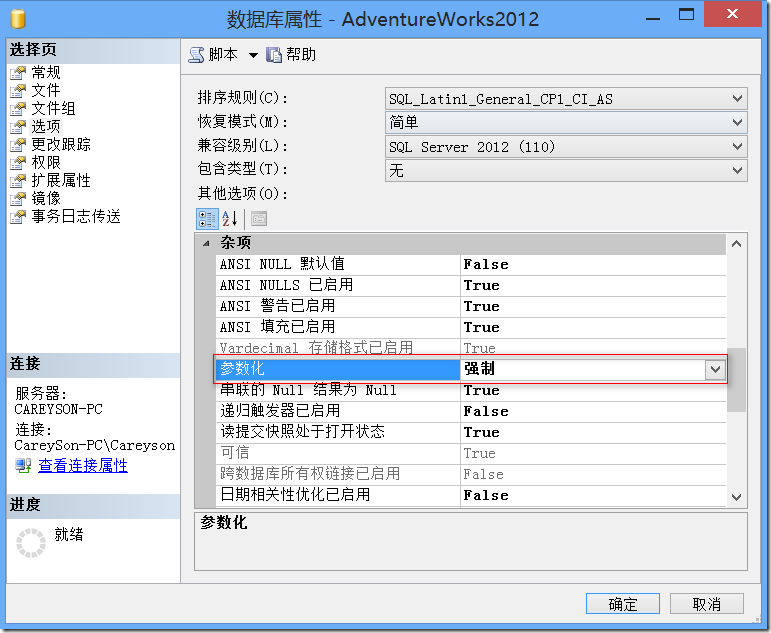
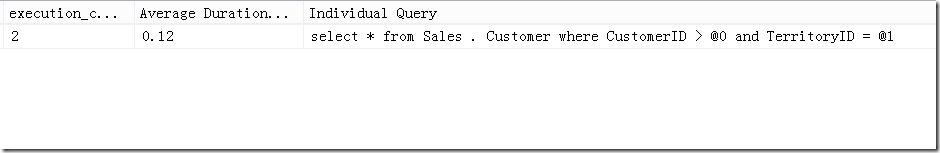
代價:最佳化器失去根據具體字面值參考統計資訊的能力,可能導致「參數嗅探」問題——首次編譯參數值不具代表性,後續不同參數沿用劣質計劃,效能劇降。
適用於 OLAP 複雜查詢:編譯成本遠低於劣質計劃執行成本。計劃不進入快取,避免汙染。
SELECT * FROM Sales.Customer
WHERE CustomerID > 20000 AND TerritoryID = 4
OPTION (RECOMPILE);
自動重編譯觸發條件:中繼資料變更、統計資訊更新、連線 SET 選項異動。
鎖定高頻參數值的最佳計劃並快取,犧牲低頻參數效能換取整體吞吐最大化。
DECLARE @vari INT = 4;
SELECT * FROM Sales.Customer
WHERE CustomerID > 20000 AND TerritoryID = @vari
OPTION (OPTIMIZE FOR (@vari = 4));
SQL Server 2008+ 新增 OPTIMIZE FOR UNKNOWN:忽略區域變數初始值,改用統計資訊密度向量估算,適合參數值分布極不均勻的情境。
在預存程序內以區域變數接收參數值,最佳化器無法嗅探,改用平均密度估算。計劃穩定但估算不精準,非首選方案。
CREATE PROC TestForLocalVari @vv INT AS
DECLARE @vari INT = @vv;
SELECT * FROM Sales.Customer
WHERE CustomerID > 20000 AND TerritoryID = @vari;
當無法修改 T-SQL(第三方應用、程式碼凍結)時,透過 sp_create_plan_guide 在查詢進入引擎瞬間注入 Hint。
EXEC sp_create_plan_guide
    @name = N'MyPlanGuide1',
    @stmt = N'SELECT * FROM Sales.Customer WHERE CustomerID > 20000 AND TerritoryID = @vari',
    @type = N'SQL',
    @module_or_batch = NULL,
    @params = N'@vari int',
    @hints = N'OPTION (RECOMPILE)';
關鍵: @stmt 必須與實際批次文字逐字完全相符(含空白、換行),否則不匹配。
資料庫層級啟用強制參數化,但特定查詢需保持簡單參數化時使用。
DECLARE @stmt NVARCHAR(MAX), @params NVARCHAR(MAX);
EXEC sp_get_query_template
    N'SELECT * FROM Sales.Customer WHERE CustomerID > 20000 AND TerritoryID = 2',
    @stmt OUTPUT, @params OUTPUT;
EXEC sp_create_plan_guide
    N'MyTemplatePlanGuide', @stmt, N'TEMPLATE', NULL, @params,
    N'OPTION(PARAMETERIZATION SIMPLE)';
執行計劃快取追求極致重用以節省 CPU 與記憶體;查詢最佳化器追求精準計劃以縮短執行時間。兩者目標在參數敏感性查詢上天然衝突。實務上應依據負載特性(OLTP vs OLAP)、參數分布、編譯頻率,靈活組合上述策略,而非單一依賴預設行為。