SQL 查詢的書寫順序(SELECT-FROM-WHERE...)與邏輯處理順序(FROM-WHERE-GROUP BY-HAVING-SELECT-ORDER BY)並不相同。本文釐清邏輯處理流程,並透過多維度實測破解「SELECT 1 比 SELECT * 快」的流傳迷思。
-- 書寫順序
SELECT empid, YEAR(orderdate) AS orderyear, COUNT(*) AS numbers
FROM Sales.Orders
WHERE custid = '71'
GROUP BY empid, YEAR(orderdate)
HAVING COUNT(*) > 1
ORDER BY empid, orderyear

-- 邏輯處理順序(優化器實際執行流程)
FROM Sales.Orders
WHERE custid = 71
GROUP BY empid, YEAR(orderdate)
HAVING COUNT(*) > 1
SELECT empid, YEAR(orderdate) AS orderyear, COUNT(*) AS numberorders
ORDER BY empid, orderyear
理解邏輯順序有助於:
測試環境:TSQL2012 範例資料庫,啟用「包含實際執行計劃」(Ctrl+M)。
IF EXISTS(SELECT 1 FROM Sales.Orders) SELECT 'SELECT 1'
IF EXISTS(SELECT * FROM Sales.Orders) SELECT 'SELECT *'
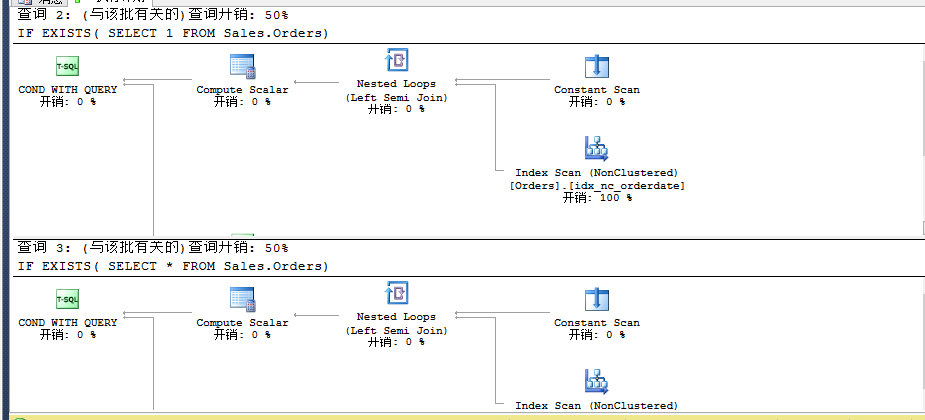
✅ 執行計劃完全一致,優化器識別出僅需存在性檢查,忽略投影列表。
CREATE INDEX ix_shipname ON Sales.Orders(shipname)
IF EXISTS(SELECT 1 FROM Sales.Orders WHERE shipname = 'Ship to 85-B') SELECT 'SELECT 1'
IF EXISTS(SELECT * FROM Sales.Orders WHERE shipname = 'Ship to 85-B') SELECT 'SELECT *'
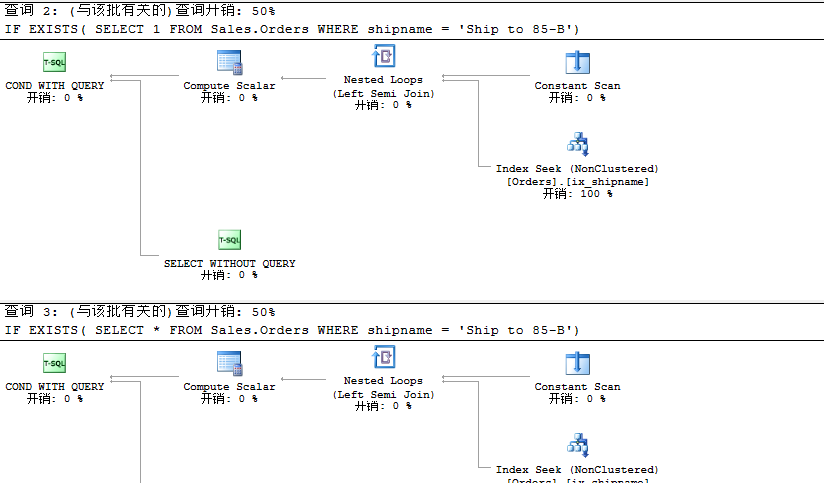
✅ 計劃一致,索引查找 + 存在性檢查,無差異。
IF (SELECT 1 FROM Sales.Orders WHERE shipname = 'Ship to 85-B') = 1 SELECT 'SELECT 1'
IF (SELECT COUNT(*) FROM Sales.Orders WHERE shipname = 'Ship to 85-B') = 1 SELECT 'SELECT *'
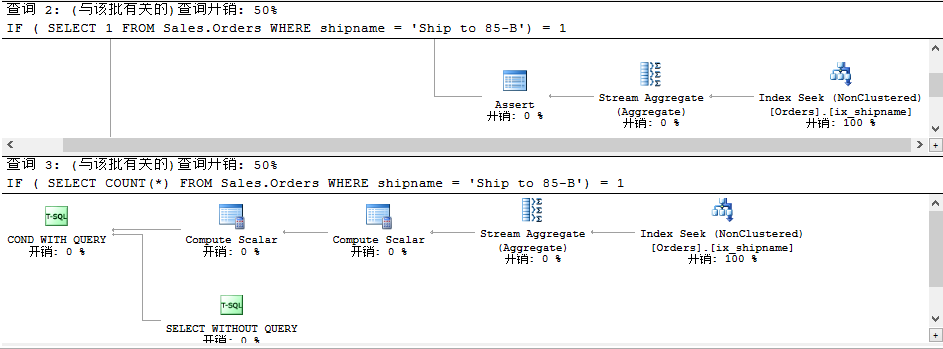
✅ 計劃一致,COUNT(*) 與常數 1 比較同樣觸發索引查找。
IF (SELECT COUNT(1) FROM Sales.Orders WHERE freight = '41.3400') = 1 SELECT 'SELECT 1'
IF (SELECT COUNT(*) FROM Sales.Orders WHERE freight = '41.3400') = 1 SELECT 'SELECT *'
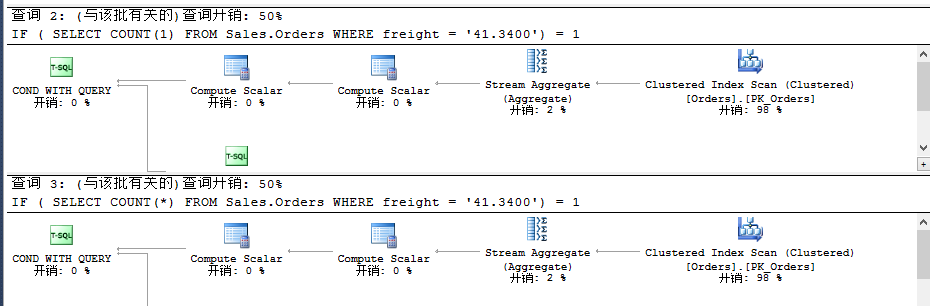
✅ 計劃一致,全表掃描 + 計數,COUNT(1) 與 COUNT(*) 無差異。
SELECT custid, companyname FROM Sales.Customers AS C
WHERE country = N'USA' AND EXISTS (SELECT * FROM Sales.Orders AS O WHERE O.custid = C.custid)

SELECT custid, companyname FROM Sales.Customers AS C
WHERE country = N'USA' AND EXISTS (SELECT 1 FROM Sales.Orders AS O WHERE O.custid = C.custid)
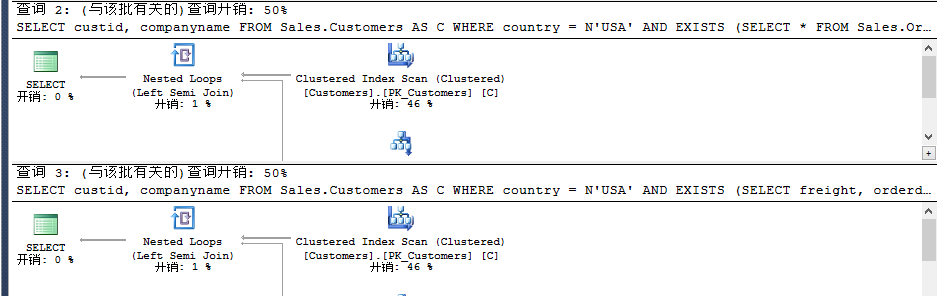
✅ 計劃一致,半連接最佳化,投影列表被忽略。
CREATE VIEW SaleOdersView AS
SELECT shipaddress, shipname,
       (SELECT unitprice FROM Sales.OrderDetails AS sod WHERE sod.orderid = so.orderid) as tc3
FROM Sales.Orders AS so

SELECT 1 FROM dbo.SaleOdersView
SELECT * FROM dbo.SaleOdersView
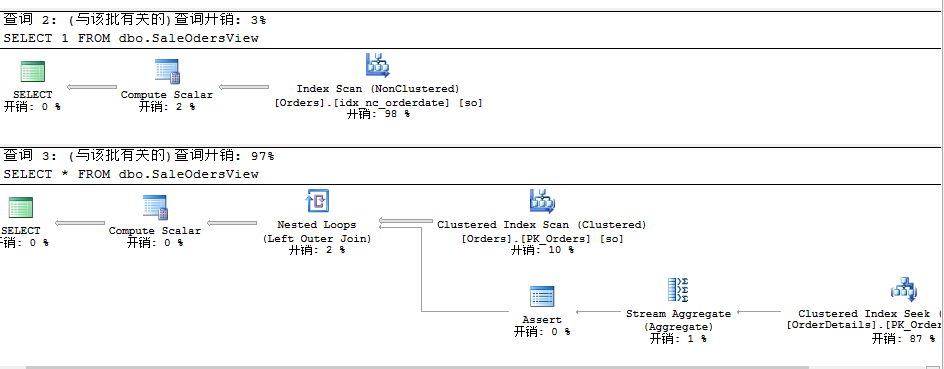
⚠️ 視圖中 SELECT * 成本 97% vs SELECT 1 成本 3%!原因:視圖定義包含標量子查詢,SELECT * 強制評估所有列含昂貴子查詢,SELECT 1 經優化器裁剪僅驗證存在性。
「在 EXISTS 子查詢中,SELECT * 與 SELECT 1 效能完全等價,優化器足夠智能忽略投影列表。SELECT * 唯一可接受的生產代碼場景就是 EXISTS 子句。」
—— SQL Server 社群共識
SELECT 1(語意清晰)或 SELECT *(無效能差異)。邏輯處理順序決定查詢語意;優化器對 EXISTS 子查詢投影列表有完善裁剪機制。SELECT 1 vs SELECT * 效能差異僅存在於視圖/衍生表含昂貴運算列時。日常開發應專注於「明確欄位列表」與「覆蓋索引設計」,而非糾結 1 與 *。