「非聚集索引葉節點存指向堆或聚集索引的指針」——這句教科書定義背後隱藏著什麼實際行為?本文透過實戰重現:建立非聚集索引後再建聚集索引,觀察查詢計劃從「表掃描」轉為「非聚集索引查找」的奧秘。
USE SQLStudy
GO
CREATE TABLE [dbo].[Test] (
    [ID] [int] NOT NULL,
    [First] [nchar](10) NULL,
    [Second] [nchar](10) NULL
)
GO

INSERT INTO [dbo].[Test] ([ID],[First],[Second])
SELECT 1,'First1','Second1' UNION ALL
SELECT 2,'First2','Second2' UNION ALL
SELECT 3,'First3','Second3' UNION ALL
SELECT 4,'First4','Second4' UNION ALL
SELECT 5,'First5','Second5'
GO

-- 先建非聚集索引
CREATE NONCLUSTERED INDEX [IX_MyTable_NonClustered] ON [dbo].[Test] ([First] ASC, [Second] ASC)
GO
SELECT ID FROM [dbo].[Test] WHERE [First] = 'First1' AND [Second] = 'Second1'
SELECT Second FROM [dbo].[Test] WHERE [First] = 'First1' AND [Second] = 'Second1'
GO
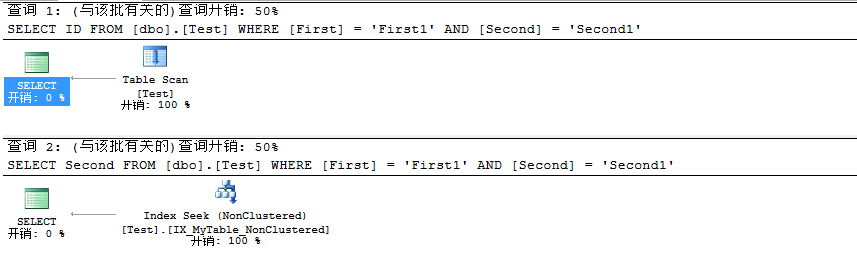
結果:
CREATE CLUSTERED INDEX [IX_MyTable_Clustered] ON [dbo].[Test] ([ID] ASC)
GO

-- 重跑相同查詢
SELECT ID FROM [dbo].[Test] WHERE [First] = 'First1' AND [Second] = 'Second1'
SELECT Second FROM [dbo].[Test] WHERE [First] = 'First1' AND [Second] = 'Second1'
GO
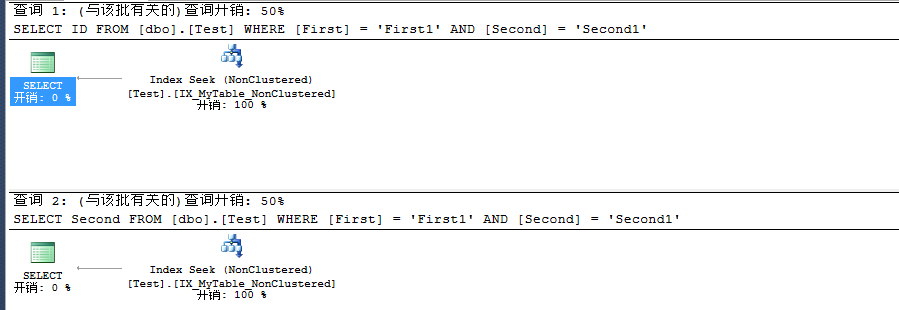
驚人變化: 兩個查詢均走非聚集索引查找!查詢 1 明明要取聚集索引鍵 ID,卻不走聚集索引查找?
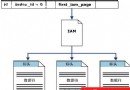
這正是定義中「指向堆或聚集索引的指針」的動態體現:聚集索引存在則指向聚集鍵,不存在則指向 RID。
聚集索引建立會觸發非聚集索引重建與指針重導向(RID → 聚集鍵)。此機制使得「查詢聚集鍵」反而可能走非聚集索引,理解此點對索引設計、效能診斷至關重要。