索引是資料庫效能調優的核心,但「建了索引就會用上」是危險迷思。本文透過實際執行計劃對比,揭示 SQL Server 為何有時放棄聚集索引而選擇非聚集索引,以及強制索引的真實影響。
假設表擁有主鍵 PK_Orders(聚集索引,鍵值 orderid)與非聚集索引 idx_nc_custid(鍵值 custid)。
USE TSQL2012
GO
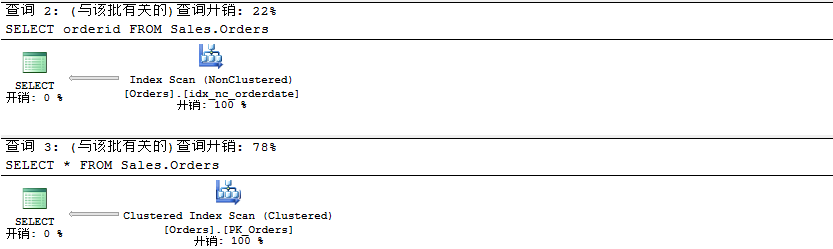
SELECT orderid FROM Sales.Orders      -- 單欄
SELECT * FROM Sales.Orders            -- 全欄
觀察:
SELECT orderid:優化器選擇非聚集索引掃描(覆蓋索引),成本極低。SELECT *:優化器選擇聚集索引掃描(需回表取所有列),成本約 3 倍。即使查詢主鍵欄位無 WHERE 條件,優化器也傾向用較窄的非聚集索引而非聚集索引。
SELECT orderid FROM Sales.Orders WITH(INDEX(PK_Orders))
SELECT * FROM Sales.Orders WITH(INDEX(PK_Orders))
強制後,單欄查詢成本大幅上升(掃描較寬聚集索引),全欄查詢成本持平。結論:單欄查詢勿強制聚集索引。
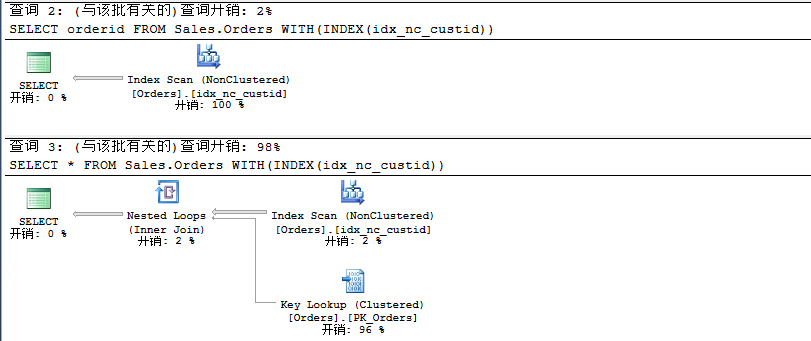
SELECT orderid FROM Sales.Orders WITH(INDEX(idx_nc_custid))
SELECT * FROM Sales.Orders WITH(INDEX(idx_nc_custid))
單欄查詢成本極低(覆蓋索引);全欄查詢觸發鍵查找,成本暴增。非聚集索引不適合 SELECT * 無過濾條件場景。
sys.dm_db_index_usage_stats 識別未用/低效索引並清理。