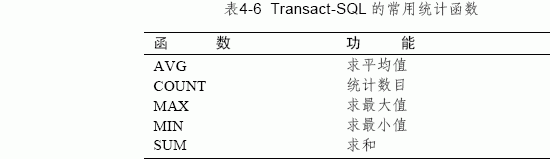
統計彙總函數 (Aggregate Functions) 是商業智慧查詢的核心,將明細資料轉化為決策指標。掌握 AVG、COUNT、SUM、MIN、MAX 的語法細節、NULL 處理、與 GROUP BY 進階搭配,是撰寫高效報表查詢的關鍵。
| 函數 | 功能 | 適用型別 | NULL 處理 | 回傳型別 |
|---|---|---|---|---|
AVG(expr) | 算術平均 | 數值型 | 忽略 NULL | 輸入型別衍生 (int→decimal, float→float) |
COUNT(expr) | 非 NULL 計數 | 所有型別 | 忽略 NULL | int |
COUNT(*) | 列計數 (含 NULL) | 所有型別 | 包含 NULL | int |
SUM(expr) | 加總 | 數值型 | 忽略 NULL | 輸入型別衍生 |
MIN/MAX(expr) | 最小/最大值 | 可排序型別 | 忽略 NULL | 輸入型別 |
SELECT [ALL | DISTINCT] 彙總函數(運算式) [, ...]
FROM 資料表
[WHERE 條件]
[GROUP BY 分組運算式 [, ...]]
[HAVING 群組條件];
提醒: 運算式必須置於括號內,多個引數以逗號分隔。
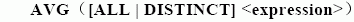
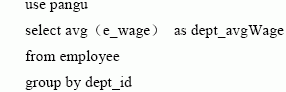
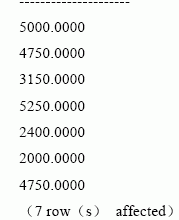
-- 範例 4-26: 求各部門平均薪資
SELECT dept_id, AVG(salary) AS avg_salary
FROM employees
GROUP BY dept_id
ORDER BY avg_salary DESC;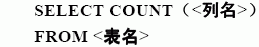
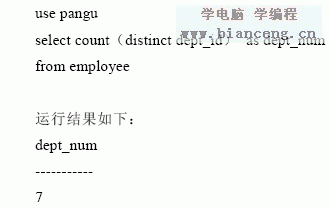
-- 範例 4-27: 計算部門數目
SELECT COUNT(DISTINCT dept_id) AS dept_count FROM employees;  -- 去重計數
SELECT COUNT(*) FROM employees;                                -- 總列數 (最快)
SELECT COUNT(manager_id) FROM employees; -- 有主管的員工數| 技巧 | 語法 | 應用場景 |
|---|---|---|
| 多層分組 | GROUP BY dept_id, job_id | 部門-職稱雙維度薪資分析 |
| ROLLUP | GROUP BY ROLLUP(dept_id, job_id) | 產生小計/總計列 (層級彙總) |
| CUBE | GROUP BY CUBE(dept_id, job_id) | 所有維度組合彙總 (交叉表) |
| GROUPING SETS | GROUP BY GROUPING SETS((dept_id),(job_id),()) | 自訂彙總組合,比 CUBE/ROLLUP 彈性 |
| GROUPING() | SELECT GROUPING(dept_id) AS is_subtotal | 識別彙總列來源,格式化報表標籤 |
WHERE 過濾,減少參與運算的列數。INDEX (group_col, agg_col) 覆蓋索引,避免 Table Scan + Hash Aggregate。COUNT(*) 最快 (僅掃描行數),COUNT(col) 需檢查 NULL,COUNT(DISTINCT col) 最慢 (需排序/雜湊去重)。AVG(dbo.fn_Calc(x))),改用 CROSS APPLY 或預先計算持久化欄位。統計函數看似基礎,但結合 GROUP BY 進階語法、窗格函數 (OVER())、近似彙總 (APPROX_COUNT_DISTINCT SQL 2019+) 能解決從操作報表到即時儀表板的多樣化分析需求。