PDW:MPP 架構下的 SQL Server 擴展,非單機資料庫替代品
Parallel Data Warehouse (PDW) 隨 SQL Server 2008 R2 推出,直指 Oracle Exadata、Teradata。**不是軟體安裝包,而是「機架級硬體設備」**。
基礎架構:雙機架起步,線性擴展
- 管理機架:管理節點、控制節點、Landing Zone 節點、備份節點。
- 資料機架:計算節點(10 核心伺服器 + 專屬 SAN 儲存),每增加一組資料機架即線性擴展 CPU/儲存/頻寬。
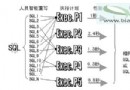
- 控制節點:查詢進入點**,解析 T-SQL → 產生分散式查詢計畫 → 下發到計算節點並行執行 → 聚合結果回傳。不儲存使用者資料,僅存中繼資料與 tempdb。
- 連線工具:Nexus Chameleon**(隨 PDW 附贈),非 SSMS。
資料分佈機制:Hash 分散,非分區表
- 建表時指定 DISTRIBUTION = HASH(欄位) 或 REPLICATE**。
- REPLICATE:維度表全量複製到每個計算節點(適合小表、頻繁聯結)。
- HASH:依指定欄位 Hash 值決定資料落在哪個計算節點,**查詢時所有節點並行掃描**,大幅縮短回應時間(天 → 分鐘)。
- 本質差異:分區表是「查一個分區」;PDW 是「所有節點一起查」。
資料載入:DWLoader 並行大量載入
- SSIS PDW 目的地介面卡、或 Landing Zone +
DWLoader(類 bcp,高效並行)。
- 載入流程:控制節點 Hash → 分發到計算節點儲存,**Hash 過程為單點瓶頸**,大量載入需規劃並行度。
三大已知短板
- INSERT 慢:每列需 Hash 計算分發,不適合高頻 OLTP 寫入。
- 聚合查詢需跨節點搬運資料:所有被聚合欄位從計算節點傳回控制節點 tempdb 再聚合,網路/IO 開銷大。
對策:表設計預先聚合、調整分散鍵、將聚合下推到計算節點(需查詢改寫)。
- 工具鏈與技能門檻高:Nexus Chameleon、DWLoader、專屬監控、MPP 查詢調優思維與傳統 SQL Server 迥異。
高可用設計
- 管理節點:雙節點 Active/Passive 叢集。
- 控制節點:Windows Server Failover Cluster。
- 計算節點:可配置獨立叢集,單節點故障不損失整體 CPU 資源。
- 專屬 AD 網域隔離,安全邊界清晰。
採購決策檢核
- ☐ 資料量 > 10 TB、查詢以大範圍掃描/聚合為主(典型 EDW/BI)。
- ☐ 寫入為批次載入(非高頻交易),可接受載入延遲。
- ☐ 團隊具備 MPP 架構師、PDW 專屬運維技能。
- ☐ 預算涵蓋硬體設備、專屬 SAN、授權、第三方工具、人員培訓。
- ☐ 評估過 Azure Synapse Analytics(雲端 MPP)替代方案。
結語
PDW 是 **專用分析設備**,非通用 SQL Server 替代品。用對場景(大規模 EDW、複雜聚合、批次載入)威力驚人;用錯場景(OLTP、高頻寫入、小資料量)則是昂貴的擺設。決策前務必深度理解其 MPP 架構、資料分佈、查詢執行模型與運維模式。