刪除重複列是開發常見痛點。游標逐列比對在百萬列級別效能極差。利用唯一索引忽略重複鍵特性,四步驟完成高效去重。
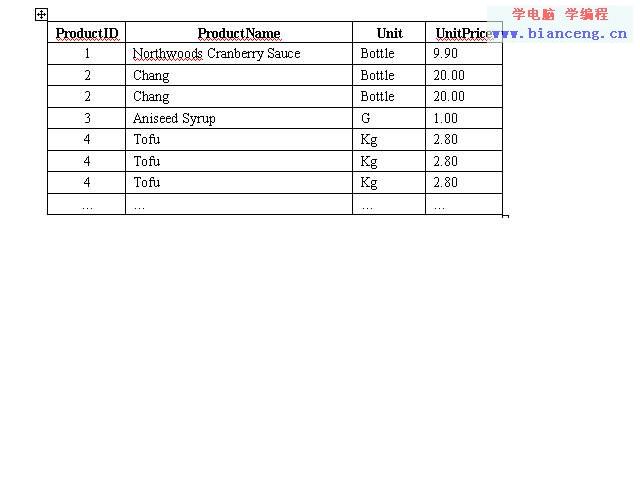
CREATE TABLE Products (
    ProductID INT,
    ProductName NVARCHAR(40),
    Unit CHAR(2),
    UnitPrice MONEY
)
CREATE TABLE Products_temp (...)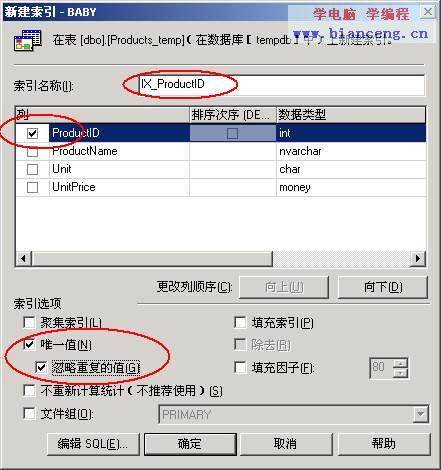
INSERT INTO Products_temp SELECT * FROM ProductsDELETE Products; INSERT INTO Products SELECT * FROM Products_temp; DROP TABLE Products_temp去重鍵選擇直接決定保留哪些列。操作前務必確認唯一索引欄位組合符合業務定義,避免誤刪有效資料。
;WITH cte AS (
    SELECT *, ROW_NUMBER() OVER (PARTITION BY ProductName ORDER BY ProductID) AS rn
    FROM Products
)
DELETE FROM cte WHERE rn > 1
CTE + 視窗函數更靈活,可精確控制保留邏輯(如保留最新/最舊/最低價)。
「唯一索引 + IGNORE_DUP_KEY + INSERT SELECT」是 SQL Server 2000 時代去重的經典最佳實務;新版本優先使用 ROW_NUMBER() 視窗函數。核心精神:用集合思維替代逐列迴圈。