首頁
編程語言
C語言|JAVA編程
Python編程
網頁編程
ASP編程|PHP編程
JSP編程
數據庫
MYSQL數據庫|SqlServer數據庫
Oracle數據庫|DB2數據庫
您现在的位置: 程式碼之家 >> 數據庫知識 >  >> SQL Server 資料庫 >> 關於SqlServer

SQL Server 聚集索引 vs 非聚集索引:核心差異與選擇指南

     編輯:關於SqlServer

一句話總結

聚集索引決定數據的物理存儲順序,每表僅能有一個;非聚集索引是邏輯順序的獨立結構,通過行定位器(RID 或聚集鍵)指向數據行,每表可建多個。

詳細對比

維度聚集索引非聚集索引
物理存儲葉級頁即數據頁,按索引鍵有序存放葉級頁存索引鍵+行定位器,不影響數據物理順序
數量限制每表 1 個每表最多 999 個 (SQL 2008+)
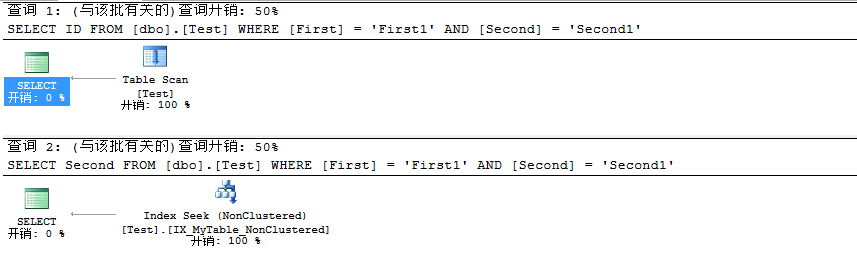
範圍查詢極優(掃描連續頁)需鍵查找回表,成本較高
覆蓋索引天然覆蓋所有列可通過 INCLUDE 列實現覆蓋
維護成本插入/更新可能導致頁分裂相對輕量,但過多會拖慢寫入
默認約束PRIMARY KEY 默認聚集UNIQUE 約束默認非聚集

非聚集索引的行定位器機制

  • 堆表:行定位器 = RID(文件號:頁號:槽號)
  • 聚集表:行定位器 = 聚集索引鍵值(隱式包含於所有非聚集索引中)

選擇建議

  1. 窄、唯一、常用於範圍查詢/排序/分組的列優先做聚集索引(如身份證號、訂單日期)
  2. 高頻點查詢、JOIN 條件、WHERE 過濾列建非聚集索引
  3. 避免在頻繁更新的寬列上建聚集索引
  4. 覆蓋索引(INCLUDE)可消除鍵查找,大幅提升點查性能
  1. 上一篇文章:
  2. 下一篇文章:
Copyright © 程式碼之家 All Rights Reserved