-- 部分列重複
SELECT col1, col2, COUNT(*)
FROM table_name
GROUP BY col1, col2
HAVING COUNT(*) > 1;DELETE FROM table_name a
WHERE (col1, col2) IN (
SELECT col1, col2 FROM table_name
GROUP BY col1, col2 HAVING COUNT(*) > 1
);缺點:子查詢每次執行全表掃描,且可能誤刪所有重複行(不保留任意一條)。
-- 步驟 1:創建臨時表存重複鍵值
CREATE TABLE tmp_dup AS
SELECT col1, col2 FROM table_name
GROUP BY col1, col2 HAVING COUNT(*) > 1;

-- 步驟 2:高效刪除
DELETE FROM table_name a
WHERE (a.col1, a.col2) IN (SELECT col1, col2 FROM tmp_dup);
優勢:子查詢變為臨時表掃描,避免重複計算,刪除速度提升數量級。
Oracle 隱藏列 ROWID 唯一標識物理位置,越新插入的行 ROWID 通常越大(非絕對,但極高概率)。
-- 查詢每組重複中 ROWID 最大(最新)的記錄
SELECT MAX(ROWID) FROM table_name
GROUP BY col1, col2 HAVING COUNT(*) > 1;

-- 刪除除最新外的所有重複行
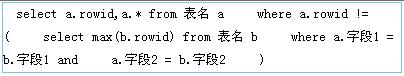
DELETE FROM table_name a
WHERE ROWID NOT IN (
  SELECT MAX(ROWID) FROM table_name
  GROUP BY col1, col2 HAVING COUNT(*) > 1
);
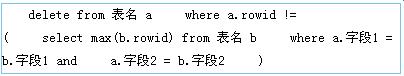
DELETE FROM table_name a
WHERE ROWID > (
  SELECT MIN(ROWID) FROM table_name b
  WHERE a.col1 = b.col1 AND a.col2 = b.col2 ... -- 全列比較
);DECLARE
v_deleted NUMBER := 1;
BEGIN
WHILE v_deleted > 0 LOOP
DELETE FROM table_name
WHERE ROWID IN (
SELECT RID FROM (
SELECT ROWID RID, ROW_NUMBER() OVER (PARTITION BY col1, col2 ORDER BY ROWID) RN
FROM table_name
) WHERE RN > 1
AND ROWNUM <= 10000 -- 每批 1 萬行
);
v_deleted := SQL%ROWCOUNT;
COMMIT;
END LOOP;
END;CREATE UNIQUE INDEX ...);