 Oracle 核心物件深度解析:同義詞、序列與視圖的建立、管理與實戰應用
一、同義詞:提供物件的別名與位置透明性 1. 基本建立語法 CREATE [PUBLIC] SYNONYM synonym_name FOR [schema.
跨資料庫分頁查詢速查表:七大主流資料庫 SELECT TOP 寫法大不同
前言:分頁查詢的標準化陷阱 SQL:2008 標準引入 OFFSET ... FETCH,但各資料庫廠商實作時機與語法差異極大。開發跨平台應用或進行異構遷移時,
Windows 下精準斬殺 Oracle 問題執行緒:ORAKILL 實戰手冊
痛點:單一 Session 佔滿資源,卻不能重啟整個實例 Windows 架構下,Oracle 所有背景與前景進程皆運行於單一 ORACLE.EXE 進程內,以
Oracle 索引優化鐵律:三個「適當」打造高效能資料庫
核心觀念:索引非越多越好,而在於「適當」 建立索引雖簡單,但要達到「適當的表、適當的欄位、適當的數量」三個適當,卻是考驗 DBA 功力的關鍵。盲目建立索引不僅無
Oracle PGA (Program Global Area) 核心機制深度解析:排序、會話、堆疊、游標區
PGA 是伺服器進程專用的私有記憶體區域,直接決定排序效能、並發承載與記憶體壓力。本文深入剖析 PGA 四大子區 (排序區、會話區、堆疊區、游標區) 運作原理、
Oracle 10g 遺失所有線上重做日誌檔 (Redo Log) 的完整復原實戰
案例背景 環境:Windows XP + Oracle 10.2.0.1 模式:非歸檔模式 (NOARCHIVELOG) 備份:完全無備份 現象:啟動資料庫報
Oracle 層次查詢利器:SYS_CONNECT_BY_PATH 函數完整攻略
函數定位與應用場景 SYS_CONNECT_BY_PATH 是 Oracle 專為層次查詢設計的分析函數,能將從根節點到當前節點的路徑,以指定分隔符串連成單一字
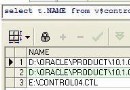 控制檔多路復用實戰指南:原理、Windows 部署與避坑要點
為什麼控制檔如同作業系統的「登錄表」? 控制檔記錄了資料庫的物理結構資訊(資料檔、重做日誌檔位置、檢查點資訊等),一旦損壞且無備份,資料庫將無法啟動。正如 Wi
打破迷思:刪除控制檔並不會導致 Oracle 實例關閉
前言:一個被廣泛誤解的行為 在日常的資料庫管理與測試中,許多 DBA 都認為:若目前的控制檔被誤刪除,Oracle 實例會立即關閉。然而,透過實際測試可以發現,
Oracle 批量 FETCH 進階技巧:集合與 %ROWTYPE 結合簡化代碼
基本 BULK COLLECT INTO 模式 將游標一次性抓取多行至 PL/SQL 集合,減少 Context Switch,大幅提升批量處理效能。 寫法演
徹底刪除 Oracle 表:繞過回收站的 PURGE 與 DROP PURGE 完全指南
10g 回收站機制回顧 Oracle 10g 引入 Recycle Bin:DROP TABLE 不再物理刪除,而是重命名為 BIN$...==$0 移入回收站
大型 Oracle 資料庫架構設計:從 RAC 應用劃分到儲存規劃全景指南
超大型系統特徵 用戶百萬~千萬級,資料量 1TB+。 7×24 無停機,極高可用性與擴展性要求。 典型架構:雙節點/多節點 Oracle RAC(舊
Oracle 索引設計三部曲:對的表、對的欄位、對的數量
核心原則:三個「適當」 索引並非越多越好。設計準則只有一句:在適當的表、適當的欄位、建立適當數量的索引。以下逐層拆解。 一、 判斷「適當的表」:大小與存取模式
ASP 惡意程式碼分析:利用 Shell.Application 遞歸清空網站目錄檔案內容
⚠️ 安全警示:惡意程式碼分析與防禦 本文僅供安全研究與防禦分析目的,嚴禁用於攻擊行為。 該程式碼可遞歸清空 Web 站點目錄下所有檔案內容(大小歸零),屬破壞
Oracle 效能調優實戰:EXISTS/IN 選擇、BULK COLLECT 陷阱與批量刪除最佳模式
子查詢改寫層級 IN → EXISTS:半連接機制,通常明顯優於 IN(特別是外部表大、內部表小)。 EXISTS → 表連接:必須將大表放在 FRO
資料庫崩潰實戰紀實:從磁碟錯誤到 BBED 修復的完整還原路徑
事故現場:連環災難 某企業核心資料庫在節假日期間發生嚴重故障,癥狀疊加: 主機核心錯誤: kernel: sda5: attempt to access
Oracle 核心架構 25 條必背鐵律:從表空間到實例關係圖譜
邏輯與物理結構鐵律 一個表空間僅屬於一個資料庫。 每個資料庫至少一個控制檔(建議 3 個,分置不同磁碟)。 每個資料庫至少一個表空間(SYSTEM
檢查點調優藝術:在恢復速度與執行效能間尋找平衡點
檢查點的雙重角色 檢查點觸發 DBWn 將「髒緩衝區」寫入資料檔,確立資料庫一致性邊界。間隔越短 → 恢復越快(重做日誌掃描少),但 I/O 衝突越頻繁 → 吞


