首頁
編程語言
C語言|JAVA編程
Python編程
網頁編程
ASP編程|PHP編程
JSP編程
數據庫
MYSQL數據庫|SqlServer數據庫
Oracle數據庫|DB2數據庫
您现在的位置: 程式碼之家 >> 數據庫知識 >  >> Oracle 資料庫 >> Oracle 資料庫基礎

案例實戰:Redo Log 全群組 ACTIVE 導致資料庫掛住 — 根因竟是 RAID 5 磁碟損壞

     編輯:Oracle 資料庫基礎

環境與現象

  • 平台:SunOS 5.8 (SPARC) + Oracle 8.1.5
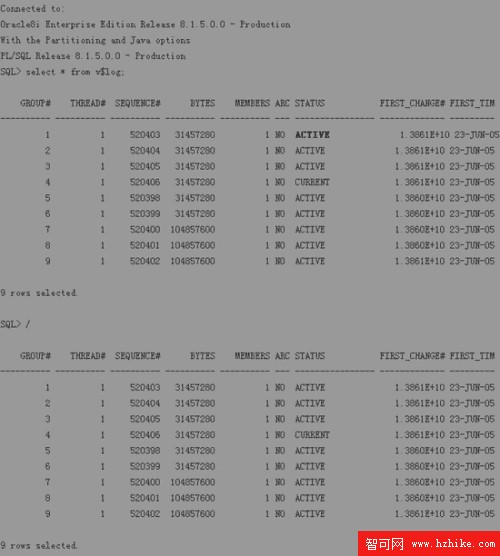
  • 症狀:應用回應極慢、請求逾時;登入資料庫發現 **除 CURRENT 外所有 Redo Log 群組均為 ACTIVE** 狀態,無法切換。

Redo Log 群組狀態圖

圖 1:V$LOG 顯示多群組 ACTIVE,僅 CURRENT 正常

診斷邏輯與證據鏈

1. 判斷:DBWR 寫入跟不上 Checkpoint

Log Switch 觸發 Checkpoint,要求 DBWR 將髒塊刷盤。若所有非 Current 群組皆 ACTIVE,代表 **Checkpoint 未完成**,LGWR 無法覆寫舊 Redo,系統卡住。
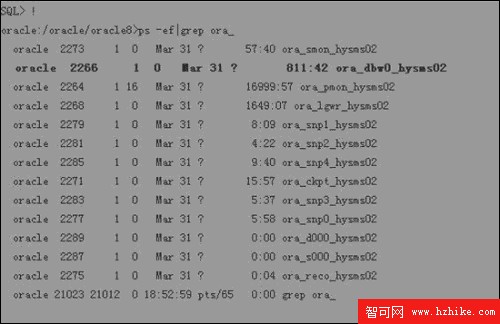
2. 檢查 DBWR 進程忙碌度

DBWR 進程資訊

圖 2:DBWR PID=2266

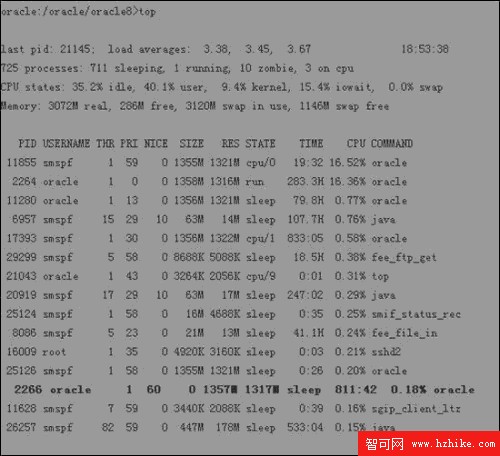
用 top 觀察:

top 輸出

圖 3:PID 2266 CPU 佔用僅 0.18% — DBWR 並未忙於運算

→ **瓶頸不在 CPU,極大機率在 I/O 子系統。**
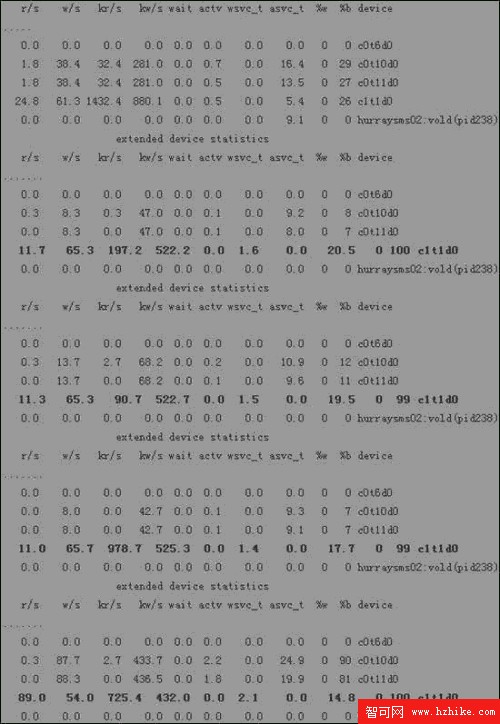
3. iostat 確認磁碟 I/O 狀態

iostat 輸出

圖 4:核心資料卷 c1t1d0 (存放資料檔)

  • %b (Busy) 持續 99-100% — 磁碟完全飽和
  • Kw/s (Write KB/sec) 僅 ~500 KB/s — 寫入速度極慢

對比:同級 T3 RAID 陣列循序寫理論值 ~10 MB/s,隨機寫正常 1-2 MB/s。實測 500 KB/s **異常偏低兩個數量級**。

根因確認與處置

硬體巡檢發現:**RAID 5 陣列中有一顆實體磁碟損壞**,陣列進入降級模式 (Degraded),重建校驗資料導致寫入效能崩潰。

  1. 更換故障磁碟,等待 RAID 重建完成。
  2. 系統 I/O 速度恢復正常,DBWR 寫入跟上,Checkpoint 完成,Redo Log 群組陸續轉為 INACTIVE。
  3. 應用回應時間恢復正常。

核心啟示

  1. Redo Log 全 ACTIVE = Checkpoint 卡住,首查 DBWR → 再查 I/O。
  2. DBWR CPU 低但系統卡 = I/O 瓶頸鐵律,必須用 iostat/sar -d 量化確認。
  3. RAID 5 降級模式寫入效能災難,生產環境務必配置熱備磁碟 (Hot Spare) 並啟用預測性失效分析 (SMART/PFA)。
  4. 監控指標建議納入:V$LOG 群組狀態、V$SYSTEM_EVENT log file switch (checkpoint incomplete) 等待事件、OS 層 %util/await/svctm。

  1. 上一篇文章:
  2. 下一篇文章:
Copyright © 程式碼之家 All Rights Reserved