看似基礎的 VARCHAR(n) 和 LIMIT,實則藏著版本差異與性能陷阱,實測驗證最可靠。
結論:MySQL 4.1+ 版本中,n 表示字符數,而非字節數。一個漢字、一個英文、一個數字均計為 1 個字符。
CREATE TABLE `test` (
  `name` VARCHAR(5) NOT NULL DEFAULT '',
  `info` CHAR(5) NOT NULL DEFAULT '',
  PRIMARY KEY (`name`)
) ENGINE=MyISAM DEFAULT CHARSET=utf8mb4;

INSERT INTO test VALUES ('abcde', 'abcde');      -- 5 英文字符 ✓
INSERT INTO test VALUES ('你好嗎', '你好嗎');    -- 3 漢字 ✓
INSERT INTO test VALUES ('你好世界', '你好世界'); -- 4 漢字 ✗ 報錯 Data too long官方文檔佐證:
MySQL 4.1 前:長度單位為字節。
MySQL 4.1+:長度單位為字符。
dev.mysql.com/doc/refman/4.1/en/char.html
CHAR(5) 定長,不足右填空格,檢索時尾部空格被截斷VARCHAR(5) 變長,存實際長度 + 1-2 字節長度前綴VARCHAR(5) 最大佔 5×4+2=22 字節time 字段有索引,關閉查詢緩存SET profiling=1 精確計時-- A: 深分頁 OFFSET 2000
SELECT id, time, title FROM cnblogs WHERE time >= 1315646940 ORDER BY time ASC LIMIT 2000, 10;
-- B: 淺分頁 LIMIT 10
SELECT id, time, title FROM cnblogs WHERE time >= 1315646940 ORDER BY time ASC LIMIT 10;
-- C: 無 WHERE 深分頁
SELECT id, time, title FROM cnblogs ORDER BY time ASC LIMIT 3000, 10;| SQL | 耗時 | 原因 |
|---|---|---|
| A (LIMIT 2000,10) | ~15ms | 需掃描 2010 行索引,丟棄前 2000 行 |
| B (LIMIT 10) | ~0.5ms | 直接取前 10 行,極快 |
| C (LIMIT 3000,10) | ~25ms | 全表索引掃描 3010 行 |
核心結論:LIMIT offset, rows 需掃描 offset + rows 行,offset 越大越慢。LIMIT rows (等同 LIMIT 0, rows) 極快。
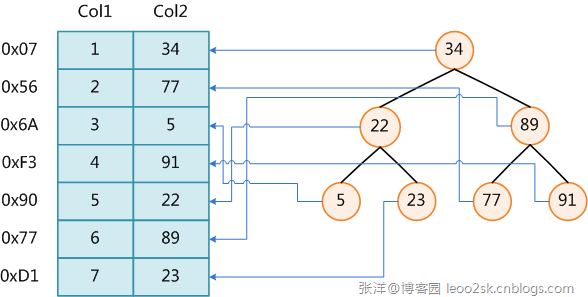
業務分頁(如「加載更多」)改用 記住上次最大/最小值:
-- 首頁
SELECT id, time, title FROM cnblogs WHERE time >= 1315646940 ORDER BY time ASC LIMIT 10;
-- 記住最後一行 time = 1315647000

-- 下一頁:用上次最大值作為新起點
SELECT id, time, title FROM cnblogs
WHERE time >= 1315646940 AND time > 1315647000
ORDER BY time ASC LIMIT 10;VARCHAR(n) 理解為字符數,按業務最大長度+裕量設置LIMIT 大偏移量,優先用 Seek 法(基於唯一遞增鍵)EXPLAIN 確認 type=range、key=索引名、rows 為預期行數LIMIT 子查詢回表優化