將單表按某字段規則(如用戶 ID 取模、時間範圍、字串 Hash)將行數據分散到多個表/庫,每個表包含部分數據。本質是按行切分。
電商、遊戲業務核心表多關聯會員 ID,適合按 user_id % N 分片。不同用戶數據落入不同庫,關聯查詢無跨庫交互。
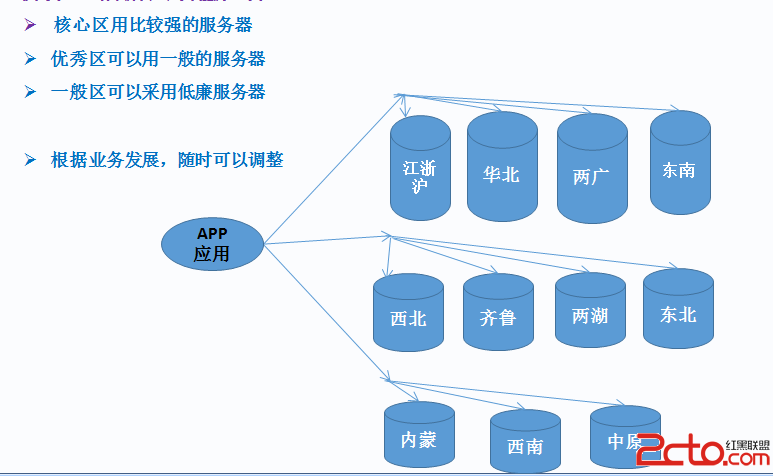
如全國劃 10 大片區(江浙滬、齊魯、兩廣等),業務量大的片區配高配伺服器,量小的配普配。資源規劃內部化,不對外宣稱。
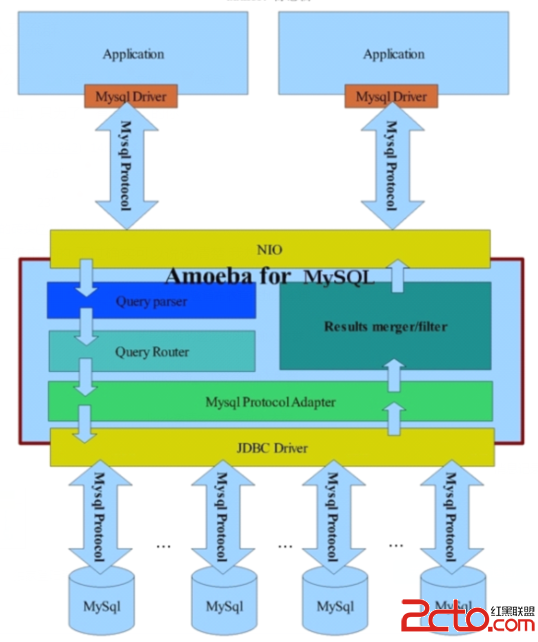
數據分佈多庫後,原本單庫事務可能跨庫。MySQL 5.0+ 僅 InnoDB 支援 XA 分布式事務,但效能差、異常處理難。
變通方案:應用層協調多個單庫本地事務,應用需具備足夠健壯性。
數據源分佈不同庫,無法直接 JOIN。
方案:應用層先查驅動表結果集,再按結果集去被驅動庫查數據,最後應用層組裝。雖有效能損耗,但因單庫負載下降,單查詢響應反而可能更快。Federated 引擎可嘗試但風險大(遠端結構變更本地不同步)。
數據源分佈多節點,單 SQL 無法完成排序分頁。
方案:應用層並行從各節點取數據,合併排序後分頁。無驅動/被驅動順序關係,並行度高,效能損耗比跨庫 JOIN 更小。應用層需消耗更多記憶體合併結果集。
所有跨節點難題建議在應用層解決。應用易擴展,資料庫擴展代價大且難避免新問題。為整體擴展性,讓應用承擔更多邏輯是值得的取捨。
參考:多實例部署指南
CREATE DATABASE hwdb DEFAULT CHARSET utf8;
CREATE TABLE uc_user(
    user_id BIGINT PRIMARY KEY,
    uc_name VARCHAR(200),
    created_time DATETIME
) ENGINE=InnoDB CHARSET utf8;

GRANT INSERT,UPDATE,DELETE,SELECT ON hwdb.* TO 'tim'@'192.168.%' IDENTIFIED BY 'timgood2013';
public class MySQLTest {
    public String getDBPort(long user_id) {
        long mod = user_id % 3;
        if (mod == 1) return "3308";
        if (mod == 2) return "3309";
        return "3307";
    }
    public Connection getConn(String port) throws Exception {
        Class.forName("com.mysql.jdbc.Driver");
        String url = "jdbc:mysql://192.168.52.130:" + port + "/hwdb";
        Connection conn = DriverManager.getConnection(url, "tim", "timgood2013");
        System.out.println("the current db is :" + url);
        return conn;
    }
    public int insert(Connection conn, BigInteger user_id, String name) throws SQLException {
        String sql = "INSERT INTO hwdb.uc_user(user_id,uc_name,created_time) VALUES(?,?,?)";
        PreparedStatement ps = conn.prepareStatement(sql);
        ps.setLong(1, user_id.longValue());
        ps.setString(2, name);
        ps.setString(3, getTimeByCalendar());
        return ps.executeUpdate();
    }
    // ... getTimeByCalendar() 省略
}
User ID 規則:註冊時間戳 + 4 位流水號(如 2015053010401005)。
ID % 3 餘 0→db1(3307)、餘 1→db2(3308)、餘 2→db3(3309)。
插入 2015053010401005/6/7 後,分別在對應實例查詢到數據,驗證路由正確。
取模分片邏輯清晰,生產環境複雜度遠高於此,但核心理念一致。這條路光明,放心走下去。