MySQL 性能優化全攻略(下):Schema 設計、事務隔離、分庫分表、緩存與搜索架構
本文為《MySQL 性能調優與架構設計》讀書筆記第二部分,聚焦高效模型設計、數據類型選型、事務隔離級別、垂直/水平拆分策略、分布式事務與跨節點查詢難題,以及 Redis/搜索引擎的協同架構。
一、 高效 Schema 設計四大模式
- 適度冗余,減少 JOIN:在從表冗余主表高頻查詢列(如訂單表冗余用戶姓名、商品標題),用空間換查詢性能,配合觸發器/應用層保證一致性。
- 大字段垂直拆分:將 TEXT/BLOB/長 VARCHAR 移至獨立表(1:1 關聯),主表保留高頻小列,提升緩存命中率、減少磁碟 IO。
- 大表水平拆分:按業務維度(時間、用戶 ID 取模、地區)將單表拆為多表/多庫,單表控制在 2000 萬行以內。
- 統計表準實時預聚合:核心指標(PV/UV/GMV)通過定時任務/流計算預聚合至統計表,前端直接查詢,避免大表實時聚合。
二、 合適的數據類型選型指南
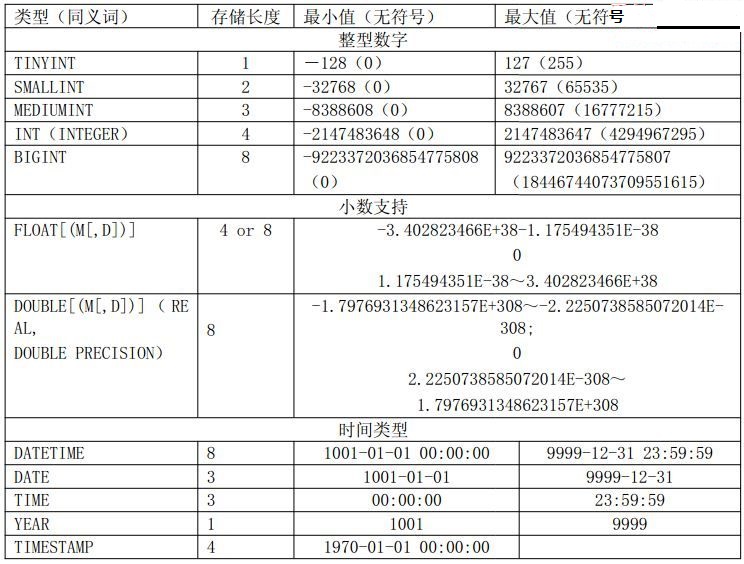
時間類型選型
| 類型 | 存儲 | 範圍 | 時區感知 | 建議 |
|---|
| DATETIME | 8 字節 | 1000-9999 年 | 否 | 歷史/未來日期、無需時區轉換 |
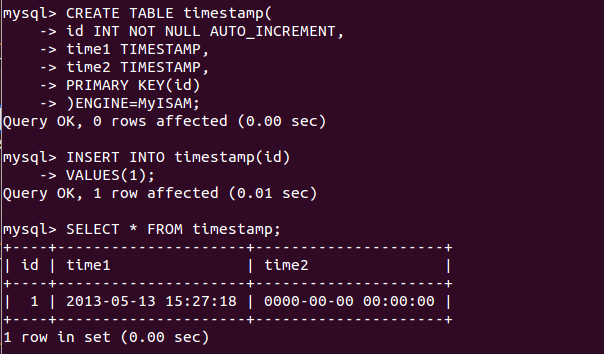
| TIMESTAMP | 4 字節 | 1970-2038 年 | 是(會話時區) | 業務時間、自動更新、節省空間 |
| DATE | 3 字節 | 1000-9999 年 | 否 | 僅需日期 |
結論:無 1970 年前數據需求時,優先 TIMESTAMP 節省一半空間並自帶時區轉換。
字符串類型選型
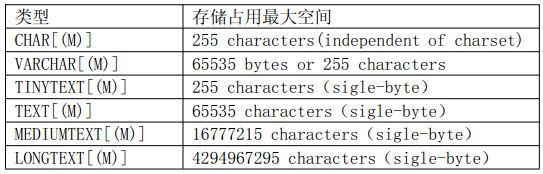
| 類型 | 長度特性 | 存儲開銷 | 適用場景 |
|---|
| CHAR(M) | 固定長度,右補空格 | M × 字符集字節數 | 定長代碼、MD5、UUID、國家代碼 |
| VARCHAR(M) | 變長,實際長度+1/2 字節 | 實際長度+1/2 字節 | 通用變長業務字段 |
| TINYTEXT/TEXT/MEDIUMTEXT/LONGTEXT | 變長,表外存儲 | 實際長度+2/3/4 字節 | 大文本、日誌、文章內容 |
注意:CHAR 讀取時尾部空格會被截斷,若業務依賴尾部空格請用 VARCHAR。
三、 事務隔離級別與鎖一致性
InnoDB 支持標準四級隔離,默認 REPEATABLE READ(RR)。
| 隔離級別 | 髒讀 | 不可重複讀 | 幻讀 | 鎖機制 | 性能 |
|---|
| READ UNCOMMITTED | ✅ 可能 | ✅ 可能 | ✅ 可能 | 無鎖讀 | 最高 |
| READ COMMITTED | ❌ | ✅ 可能 | ✅ 可能 | 行鎖 + 間隙鎖(部份) | 高 |
| REPEATABLE READ | ❌ | ❌ | ✅ 可能 | Next-Key Lock(行+間隙) | 中(默認) |
| SERIALIZABLE | ❌ | ❌ | ❌ | 表鎖/範圍鎖 | 最低 |
關鍵現象定義
- 髒讀:事務 A 讀到事務 B 未提交的修改。
- 不可重複讀:事務 A 兩次讀同一行,中間事務 B 提交了 UPDATE,結果不一致。
- 幻讀:事務 A 兩次範圍查詢,中間事務 B 提交了 INSERT,第二次多出行。
實戰建議
- 核心交易(訂單、扣款)用 RR + 顯式鎖(
SELECT ... FOR UPDATE)。
- 高並發只讀報表可用 RC 減少間隙鎖爭用,配合
binlog_format=ROW 保證復制一致性。
- 避免長事務,拆分為多個短事務或用 saga 模式。
四、 可擴展性設計:數據切分策略
垂直切分(按業務模塊拆庫/拆表)
優點:業務邊界清晰、治理簡單、單庫壓力降低。
缺點:跨庫 JOIN/事務複雜、熱點表無法拆分、擴展性有上限。
水平切分(按鍵值範圍/Hash 拆表/拆庫)
優點:單表體積可控、寫入性能線性擴展、無業務邊界限制。
缺點:路由規則複雜、跨分片 JOIN/排序/分頁難、運維成本高(DDL、備份、遷移)。
常見分片鍵選型
- 用戶 ID 取模:均勻分布,但擴容需遷移數據(一致性 Hash 緩解)。
- 時間範圍:符合日誌/訂單冷熱分離,歷史分片只讀易歸檔。
- 地區/租戶:業務天然隔離,但熱點可能不均。
五、 分庫分表帶來的三大難題與對策
| 難題 | 核心痛點 | 主流對策 |
|---|
| 分布式事務 | 跨庫原子性 | 避免跨庫事務 → 拆分為本地事務 + 應用層補償(TCC/Saga/本地消息表) |
| 跨節點 JOIN | 無法在單庫完成關聯 | 應用層組裝:先查驅動表 → 收集關聯鍵 → 批量查被驅動表 → 內存合併 |
| 跨節點排序分頁 | 全局 Top-N、深分頁 | 雙層查詢:各分片取 Top-N → 應用層歸並排序;或引入 ElasticSearch 承接複雜檢索 |
六、 引入緩存與搜索引擎的協同架構
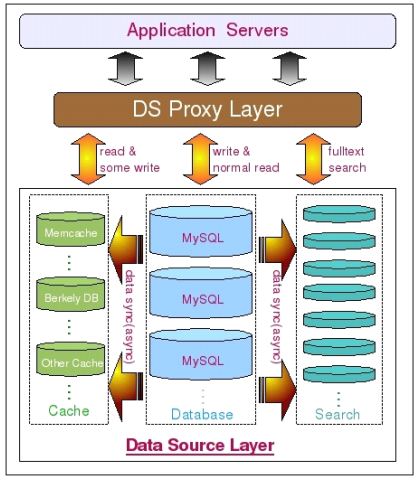
Redis / Memcached 緩存層
- 熱點數據:配置、用戶資料、權限、準實時統計,TTL 策略 + 主動更新。
- 計數器/排行榜:INCR、Sorted Set 原子操作。
- 分布式鎖/限流:SETNX、Lua 腳本。
- 多級緩存:本地緩存 + 分布式緩存,防止緩存雪崩/穿透/擊穿。
ElasticSearch / Solr 搜索引擎層
- 全文模糊搜索:倒排索引 + 分詞器,解決
LIKE '%kw%' 全表掃描。
- 多維度聚合統計:Terms/Histogram 聚合,替代 MySQL 複雜 GROUP BY。
- 日誌/審計檢索:寫入即索引,近實時可見。
- 數據同步:Canal 解析 Binlog → RocketMQ/Kafka → Logstash/自研同步至 ES。
七、 總結:從單機優化到分布式架構演進路線圖
- 單機優化:索引、SQL、參數、硬件 → 解決 80% 性能問題。
- 讀寫分離:一主多從,讀負載分流。
- 垂直拆分:業務解耦,微服務化前奏。
- 水平分表:單表突破 2000 萬行瓶頸。
- 分庫分表中間件:ShardingSphere、MyCat、Vitess 自動化路由。
- 異構協同:Redis 加速讀、ES 承接搜索/聚合、ClickHouse 承接 OLAP。
- 雲原生/Serverless:Aurora、PolarDB、TiDB 等 NewSQL 透明分片。
每一階段引入的複雜度與收益需權衡,**過早分庫分表是萬惡之源**,優先把單機優化做到極致。