MySQL 性能優化全攻略(上):架構、存儲引擎、鎖機制與查詢優化
本文為《MySQL 性能調優與架構設計》讀書筆記第一部分,系統梳理 MySQL 適用場景、架構分層、存儲引擎特性、影響性能的五大因素、鎖機制,以及 SQL 查詢優化的核心原則與索引策略。
一、 MySQL 主要適用場景
- Web 網站系統:高並發、讀多寫少、數據量中等,典型 LAMP/LNMP 架構。
- 日誌記錄系統:寫入密集、順序寫、保留周期短、查詢簡單。
- 數據倉庫/OLAP:數據量大、複雜聚合、批量載入、並發低。
- 嵌入式系統:輕量級、單機、資源受限。
二、 MySQL 架構分層(自上而下)
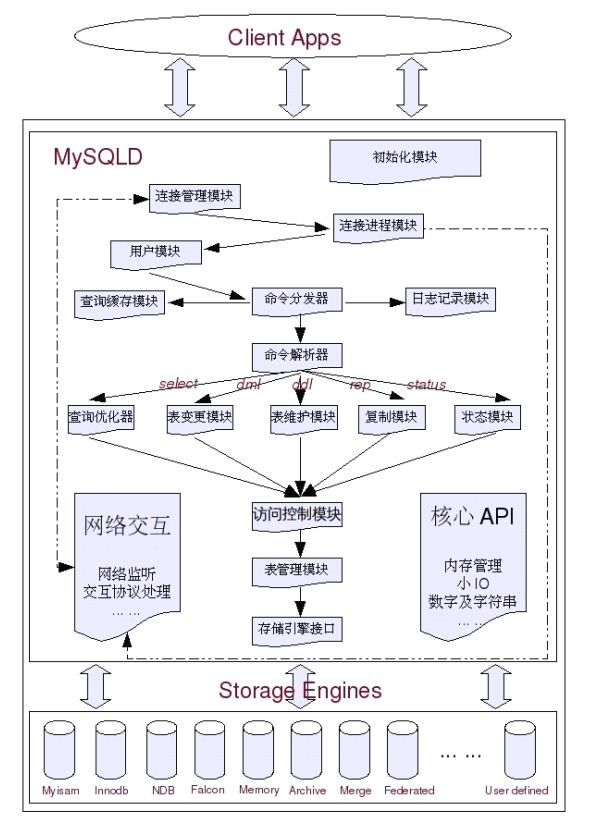
- Connectors:各語言驅動(JDBC、ODBC、.NET、PHP、Python 等),負責網絡協議解析、認證、連接管理。
- Management Services & Utilities:備份恢復、復制、集群、元數據管理、配置遷移工具。
- Connection Pool:線程池、身份驗證、連接限制、內存/緩存管理。
- SQL Interface:DML/DDL、存儲過程、視圖、觸發器解析入口。
- Parser:SQL 詞法/語法分析、權限驗證、生成解析樹。
- Optimizer:查詢重寫、訪問路徑選擇、成本估算、索引合併、子查詢優化。可通過
optimizer_switch 控制行為。
- Cache & Buffer:Query Cache(5.5/5.6)、Table Open Cache、InnoDB Buffer Pool、Key Buffer 等。
- Storage Engine:插件式存儲引擎層,InnoDB、MyISAM、Memory、NDB 等。
三、 存儲引擎全景對比
| 引擎 | 事務 | 鎖粒度 | 索引類型 | 適用場景 | 備註 |
|---|
| InnoDB | ✅ ACID | 行鎖 | B+Tree | 核心業務、高並發、數據完整性要求高 | 5.5+ 默認引擎 |
| MyISAM | ❌ | 表鎖 | B-Tree、R-Tree、Fulltext | 只讀/讀多寫少、全文搜索、日誌表 | 5.5 前默認 |
| Memory | ❌ | 表鎖 | Hash、B-Tree | 臨時表、查找表、會話數據 | 重啟數據丟失 |
| NDB Cluster | ✅ | 行鎖 | T-Tree/Hash | 高可用、分布式、內存計算 | 架構複雜 |
| Archive | ❌ | 行鎖 | 無 | 歷史歸檔、壓縮存儲 | 僅支持 INSERT/SELECT |
| CSV | ❌ | 表鎖 | 無 | 數據交換、報表導出 | 標準 CSV 文件 |
| Blackhole | ❌ | 無 | 無 | 復制中繼、審計日誌過濾 | 寫入即丟棄 |
| Federated | ❌ | 遠程 | 遠程 | 跨實例查詢(類 DBLink) | 性能差,慎用 |
| Merge | ❌ | 表鎖 | MyISAM 索引 | 分區表邏輯視圖 | 底表結構必須一致 |
| BDB | ✅ | 頁鎖 | B-Tree | 歷史遺留 | 已廢棄 |
四、 影響 MySQL Server 性能的五大因素
- 業務需求:實時性、一致性、可用性權衡決定架構選型。
- 系統架構實現:不適合存入 DB 的數據(大二進制、流水隊列、超大文本)應外移至對象存儲、消息隊列、搜索引擎;熱點數據引入 Redis/Memcached 多級緩存。
- SQL 查詢質量:小結果集驅動大結果集、避免不必要的 JOIN/子查詢、只取所需列、利用索引完成排序分組。
示例優化:
-- 方案一:大表先 JOIN 再 LIMIT(掃描 3 萬行)
SELECT u.id, u.nick_name FROM user u JOIN user_group ug ON ug.user_id=u.id WHERE ug.group_id=1 ORDER BY ug.gmt_create DESC LIMIT 100,20;
-- 方案二:小表先 LIMIT 再 JOIN(掃描 20 行)
SELECT u.id, u.nick_name FROM (SELECT user_id FROM user_group WHERE group_id=1 ORDER BY gmt_create DESC LIMIT 100,20) t JOIN user u ON u.id=t.user_id;
- Schema 設計:適度冗余減少 JOIN、大字段垂直拆分、大表水平分表、統計表準實時預聚合。
- 硬件環境:
OLTP:大內存(熱數據全內存)、高 IOPS 存儲(SSD/NVMe)、強 CPU(高主頻多核)、低延遲網絡。
OLAP:大容量存儲、高吞吐帶寬存儲、CPU 需求相對較低、集群間高帶寬網絡。
高頻小查詢:極大內存命中率、強 CPU 處理高 QPS、普通網絡即可。
五、 MySQL 鎖機制速覽
| 鎖類型 | 引擎 | 特點 | 適用場景 |
|---|
| 表鎖 | MyISAM、Memory、CSV | 開銷最小、並發度最低、死鎖少 | 只讀、低並發 |
| 行鎖 | InnoDB、NDB | 開銷大、並發度高、支持死鎖檢測 | 高並發寫入、事務 |
| 頁鎖 | BDB | 折中 | 已廢棄 |
InnoDB 行鎖模式:Record Lock(記錄鎖)、Gap Lock(間隙鎖)、Next-Key Lock(臨鍵鎖=記錄+間隙),默認 RR 隔離級別使用 Next-Key Lock 防止幻讀。
六、 SQL 查詢優化十大原則
- 優化最需要優化的 Query(高頻、慢、影響業務)。
- 定位性能瓶頸:CPU、IO、鎖、網絡。
- 明確優化目標:RT、QPS、吞吐量。
- 從
EXPLAIN 入手:關注 type、key、rows、Extra。
- 多用
PROFILE/PERFORMANCE_SCHEMA 精準定位耗時階段。
- 永遠用小結果集驅動大結果集(驅動表優先過濾)。
- 盡可能在索引中完成排序(避免 Filesort)。
- 只取出業務需要的 Columns(禁止
SELECT *)。
- 僅使用最有效的過濾條件(高選擇性優先)。
- 盡可能避免複雜 JOIN 與子查詢(衍生表物化開銷大)。
七、 索引設計實戰
B-Tree / B+Tree 索引
- InnoDB 使用 B+Tree:葉子節點雙向鏈表,掃描更快;非葉節點僅存鍵值+指針,扇出更大。
- 聚簇索引:主鍵索引葉子節點存完整行數據;二級索引葉子存主鍵值,查詢需「回表」。
- 覆蓋索引:查詢列全包含在二級索引中,避免回表。
Hash 索引
- Memory 引擎默認,僅支持
=、IN、<=>,不支持範圍、排序、前綴匹配。
- 大量哈希碰撞時性能退化。
Fulltext 索引
- MyISAM 5.6+、InnoDB 5.6+ 支持,針對 CHAR/VARCHAR/TEXT,解決
LIKE '%kw%' 低效。
- 中文需分詞插件(ngram、parser)。
創建索引決策表
| 原則 | 動作 |
|---|
| 高頻 WHERE/JOIN/ORDER BY/GROUP BY 列 | ✅ 建索引 |
| 區分度極低(如性別、狀態) | ❌ 單列索引無效,可做組合索引前綴 |
| 極高頻 UPDATE 列 | ❌ 避免索引維護開銷 |
| 不出現在 WHERE 的列 | ❌ 不建索引 |
| 長字符串列 | ✅ 前綴索引 INDEX idx_name (col(10)) |
八、 JOIN、ORDER BY、GROUP BY、DISTINCT 優化要點
- JOIN:小表驅動大表、被驅動表關聯列必須有索引、內存足時適當增大
join_buffer_size。
- ORDER BY:利用索引有序性避免 Filesort;增大
sort_buffer_size、減少返回列、增大 max_length_for_sort_data。
- GROUP BY:同樣利用索引排序分組;無索引時臨時表+Filesort。
- DISTINCT:本質等同
GROUP BY 取每組第一行;無索引時臨時表去重,不排序。