首頁
編程語言
C語言|JAVA編程
Python編程
網頁編程
ASP編程|PHP編程
JSP編程
數據庫
MYSQL數據庫|SqlServer數據庫
Oracle數據庫|DB2數據庫
您现在的位置: 程式碼之家 >> 數據庫知識 >  >> MySQL 資料庫 >> MySQL 綜合教學

後端分布式系列:分布式存儲-MySQL 事務與復制原理深度解析(進階版)

     編輯:MySQL 綜合教學

分布式存儲架構動態圖

系列緒論

「後端分布式」包含「分布式存儲」與「分布式計算」兩大支柱。本系列以實戰問題為導向,剖析技術原理,以開源產品為參考實現,重原理、輕細節。

核心問題:雙主多寫下的數據一致性

近期專案需在異地數據中心實現多點寫入與最終一致性。傳統讀寫分離靠主從復制即可;雙主雙寫引入延遲與衝突,本質是「分布式環境下如何保證數據一致性」。

單機一致性基石:ACID 事務

單機 MySQL 靠事務四大特性(原子性、一致性、隔離性、持久性)保證一致性。但主從架構下,主從數據一致性靠什麼?

Binlog:主從復制的數據源頭

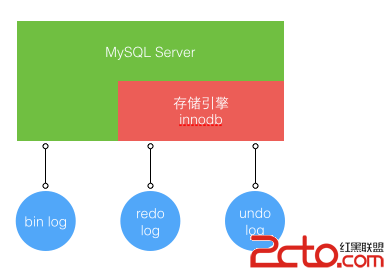
MySQL 引入 binlog 記錄所有數據變更事件。從庫拉取 binlog 重放事件重構數據。主庫只需保證「binlog 與本地數據一致」,主從數據即一致(暫忽略網絡異常)。

存儲引擎層事務實現:Redo Log + Undo Log

MySQL 通過插件式存儲引擎實現事務,InnoDB 是支持事務的主流引擎。核心機制:

  • Redo Log(重做日志):物理日志,記錄「修改後」的頁變更,WAL(Write-Ahead Logging)機制保證持久性
  • Undo Log(回滾日志):邏輯日志,記錄「修改前」的數據,支撐 MVCC 與回滾

事務執行流程:

  1. 寫 undo/redo log,強制刷盤(fsync)
  2. 修改內存數據頁(Buffer Pool),標記為髒頁
  3. 提交:redo log 寫入 commit 記錄

崩潰恢復:掃描 redo log,遇 commit 重做,無 commit 利用 undo log 回滾。

關鍵挑戰:Binlog 與 Redo Log 的一致性同步

Binlog 由 Server 層寫入,不在 InnoDB 事務管轄範圍。若兩者不一致,主從數據分歧。解決方案:將 binlog 寫入納入事務提交流程,採用內部 XA 兩階段提交(Internal XA)。
內部XA兩階段提交流程圖

開啟 Binlog 後的兩階段提交流程

Phase 1(Prepare):

  1. InnoDB Prepare:持有 prepare_commit_mutex,寫 redo log prepare 記錄,刷盤
  2. 事務狀態標記為 Prepared

Phase 2(Commit):

  1. Server 層寫 binlog,fsync 持久化
  2. InnoDB Commit:寫 redo log commit 記錄,釋放鎖

以 binlog 是否寫成功為事務提交成功與否的唯一標準。InnoDB commit 標記不是最終標準。

崩潰恢復邏輯

  1. 掃描最新 binlog 文件,提取所有 XID
  2. 遍歷 InnoDB Prepared 狀態事務鏈表,比對 XID:
    • XID 存在於 binlog → 提交事務
    • XID 不存在 → 回滾事務

此機制保證 InnoDB 與 Binlog 事務狀態強一致。

總結與後續展望

本文理清了 MySQL 單機通過「內部 XA 兩階段提交」實現 Binlog 與事務數據一致,為主從復制奠基。主從復制引入網絡因素(延遲、丟包、分區),一致性保證複雜度升級。後續將深入分析:

  • 半同步復制與損失數據風險
  • GTID 全局事務 ID 與故障切換
  • 多源復制與雙主衝突檢測
  • Binlog 組提交優化演進
  1. 上一篇文章:
  2. 下一篇文章:
Copyright © 程式碼之家 All Rights Reserved