好久沒有發表技術文章,主要在思考「後端分布式」系列該如何切入才最貼近實戰。最近理清了脈絡:後端分布式核心包含「分布式存儲」與「分布式計算」兩大板塊。本系列將結合實際工作中遇到的問題,以「尋找答案」的視角剖析技術原理。我們大多數時候不是在造輪子,而是在用輪子;為了用好輪子,必須懂其內部結構與運作邏輯。本文將從使用者角度出發,以開源產品為參考實現,重點講清原理,細節點到即止。
近期參與一個跨地域數據中心的多點寫入專案,要求在異地雙主架構下實現數據最終一致性。過去僅做讀寫分離,靠 MySQL 原生主從復制即可;如今雙主雙寫引入的短暫延遲與衝突解決,本質上仍是「如何在分布式環境下保證數據一致性」的問題。
回到最基礎的單機 MySQL,一致性靠事務的 ACID 四大特性支撐:
ACID 細節不再贅述,重點在於:單機靠事務搞定一致性,那主從架構下,主從數據一致性靠什麼?
MySQL 引入 binlog(二進制日志)實現主從復制。Binlog 記錄所有引發數據變更的事件。從庫請求主庫發送 binlog,重放事件重構數據。因此,從庫數據來源即 binlog。只要主庫做到「binlog 與本地數據一致」,主從數據便一致(暫不考慮網絡傳輸異常)。
本地數據一致性靠存儲引擎事務保證,那事務是如何實現的?請看下圖:
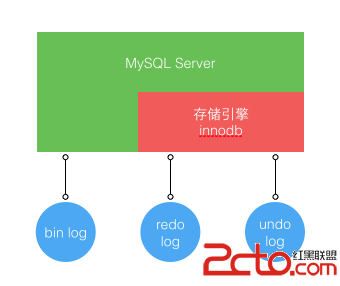
MySQL 本身不直接提供事務,而是開放存儲引擎接口,由 InnoDB 實現。通用做法基於兩類日志:
事務執行簡化流程:
若中途故障,可用 redo log 重做或 undo log 回滾,保證一致性。
上述機制在存儲引擎層完成,但 binlog 由 MySQL Server 層記錄,不在引擎管轄範圍。必須保證 binlog 與 redo log 內容一致,否則主從數據會出現分歧。
開啟 binlog 後,事務提交流程多一步:
只要 binlog 未寫成功,事務回滾;binlog 寫成功後即便 Crash 也能恢復並提交。這要求 binlog 寫入嵌入事務引擎流程,以內部分布式事務(XA 事務,兩階段提交)方式完成。
本文從「分布式一致性」切入,分析 MySQL 單機如何通過「binlog 與事務數據一致」支撐復制機制。這為後續基於 binlog 實現主從復制、解決網絡因素引入的複雜性奠定基礎。後續文章將深入剖析主從復制中的網絡延遲、衝突檢測、GTID、半同步復制等進階主題。