MySQL 內核架構、查詢執行流程與 SQL 解析順序全景圖
一、MySQL 總體架構(雙層設計)
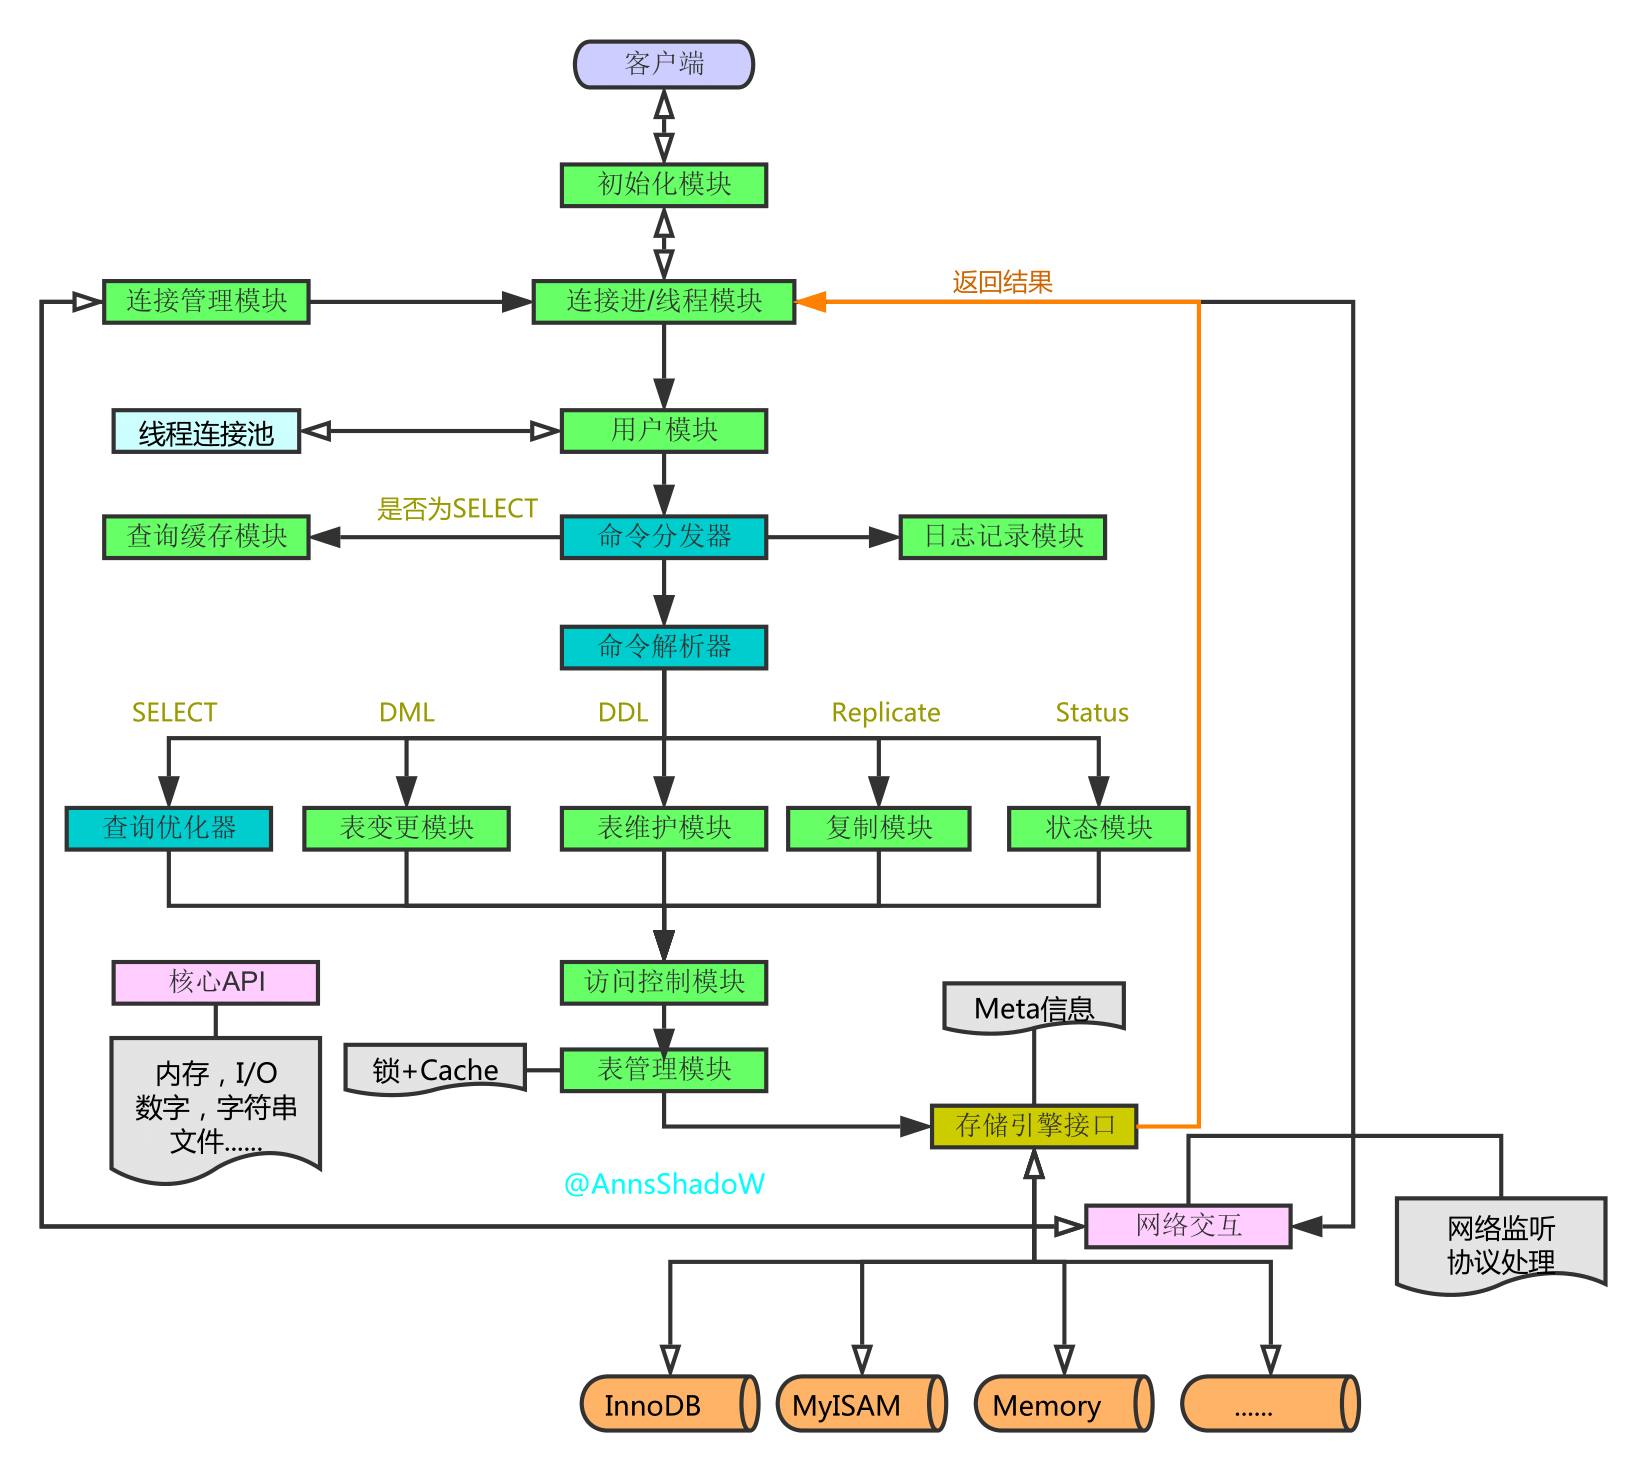
- SQL Layer (Server 層):連接管理、查詢緩存、解析器、優化器、執行器
- Storage Engine Layer:InnoDB、MyISAM、Memory 等,通過統一 Handler API 交互
二、查詢執行流程三階段
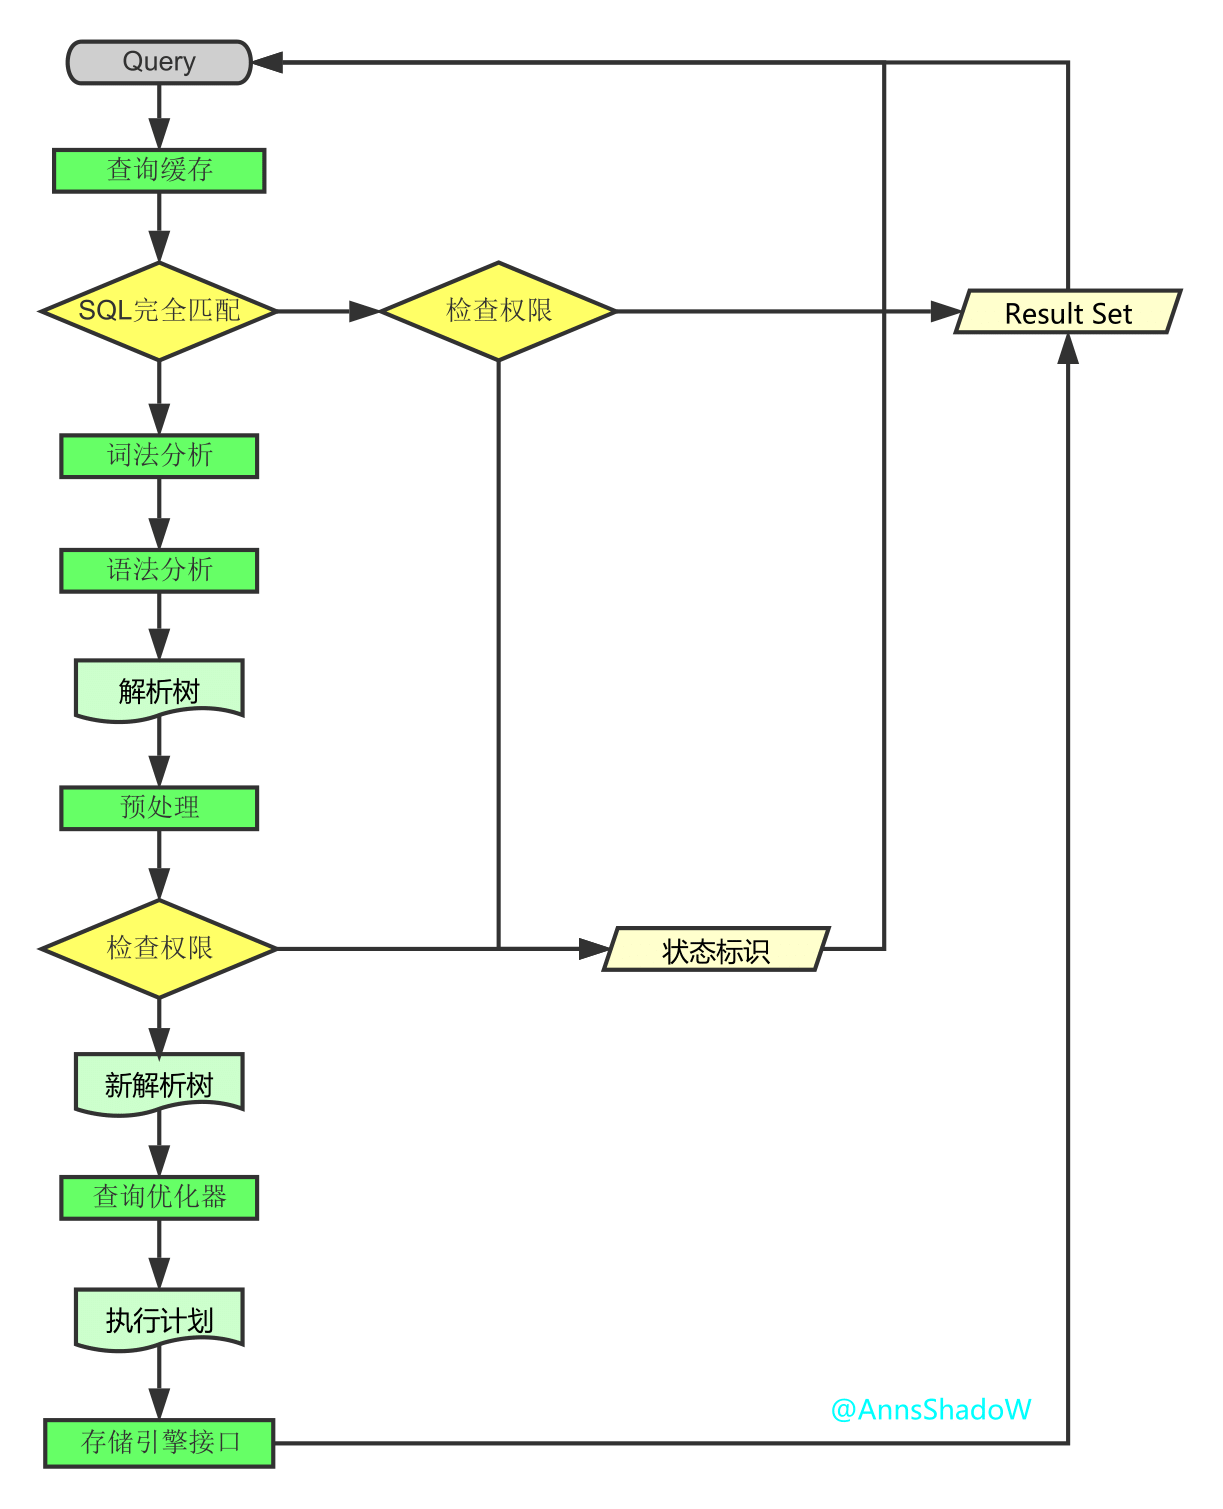
1. 連接階段
- 客戶端發起 Query → 連接管理模塊接收
- 轉發至 線程模塊 → 調用 用戶模塊 驗證權限
- 從 線程連接池 取空閒線程或創建新線程綁定會話
2. 處理階段
- 查詢緩存命中?→ 直接返回
- 未命中 → 命令解析器(詞法/語法分析) → 解析樹
- 預處理器:語義檢查、權限驗證 → 新解析樹
- SELECT → 查詢優化器 → 執行計劃
- 訪問控制模塊 → 表/列級權限
- 表管理模塊 → Table Cache 命中或打開 .frm/.ibd
- 根據元數據路由至對應存儲引擎 Handler
- 數據變更 → 寫 Binlog(若啟用)
3. 結果階段
- 結果集 / 狀態碼 返回線程模塊
- 線程清理、歸還連接池或斷開連接
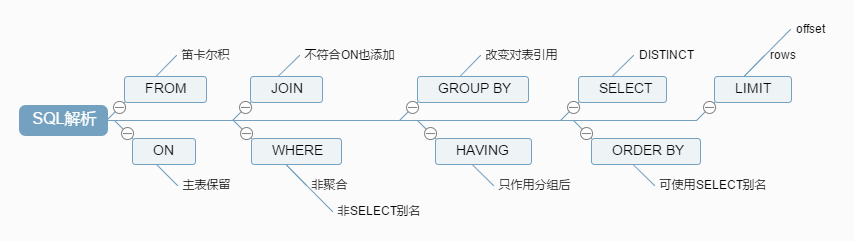
三、SQL 邏輯解析順序(與書寫順序不同)
-- 書寫順序
SELECT DISTINCT
FROM   JOIN  ON
WHERE
GROUP BY
HAVING
ORDER BY
LIMIT

-- 真實執行順序
1. FROM
2. ON
3.  JOIN
4. WHERE
5. GROUP BY
6. HAVING
7. SELECT
8. DISTINCT
9. ORDER BY
10. LIMIT
理解順序差異,能解釋:為何 WHERE 不能用別名、為何 HAVING 可用聚合函數、為何 ORDER BY 可用別名、為何 LIMIT 必須在最後。
四、逐步演示:一條完整查詢的虛擬表變遷
-- 測試數據
CREATE TABLE t1 (uid VARCHAR(10) PRIMARY KEY, name VARCHAR(10)) ENGINE=InnoDB;
CREATE TABLE t2 (oid INT AUTO_INCREMENT PRIMARY KEY, uid VARCHAR(10)) ENGINE=InnoDB;
INSERT INTO t1 VALUES ('aaa','mike'),('bbb','jack'),('ccc','mike'),('ddd','mike');
INSERT INTO t2(uid) VALUES ('aaa'),('aaa'),('bbb'),('bbb'),('bbb'),('ccc'),(NULL);

-- 目標查詢
SELECT a.uid, COUNT(b.oid) AS total
FROM t1 a LEFT JOIN t2 b ON a.uid = b.uid
WHERE a.name = 'mike'
GROUP BY a.uid
HAVING COUNT(b.oid) < 2
ORDER BY total DESC
LIMIT 1;
步驟 1-3:FROM → ON → JOIN (生成 VT1-J3)
- 笛卡爾積 28 行 → ON 過濾 6 行 → LEFT JOIN 加外部行 → 7 行 (VT1-J3)
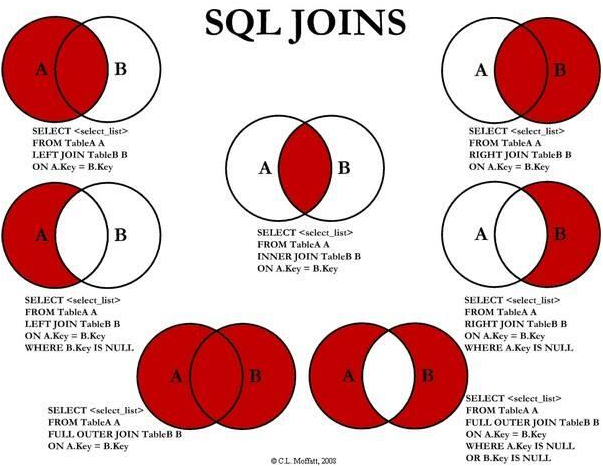
步驟 4:WHERE 過濾 (VT2)
WHERE a.name = 'mike' → 保留 aaa, ccc, ddd (4 行)
步驟 5:GROUP BY (VT3)
GROUP BY a.uid → 分 3 組 (aaa, ccc, ddd)
步驟 6:HAVING 過濾組 (VT4)
HAVING COUNT(b.oid) < 2 → 保留 ccc(1), ddd(0) (2 行)
步驟 7-8:SELECT + DISTINCT (VT5)
SELECT a.uid, COUNT(b.oid) AS total → 產生 (ccc,1), (ddd,0)
步驟 9:ORDER BY (VT6)
ORDER BY total DESC → (ccc,1) 在前
步驟 10:LIMIT (最終結果)
LIMIT 1 → (ccc,1)
五、關鍵優化啟示
- WHERE 早過濾:在 JOIN 前用子查詢縮小驅動表
- GROUP BY 推下:能在 JOIN 前聚合則先聚合
- LIMIT 大偏移優化:子查詢取主鍵 ID → 回表 JOIN
- DISTINCT 代價:需建內存臨時表 + 唯一索引,能用 GROUP BY 替代則替代
六、參考書籍
- 《MySQL性能調優與架構實踐》
- 《MySQL技術內幕:SQL編程》