SELECT COUNT(DISTINCT a) FROM table1; -- a 上有索引
早期版本(≤5.1)執行計劃:type=index, Extra=Using index → **索引全掃描**,逐行讀取、去重,效率極低。
SELECT COUNT(*) FROM (SELECT DISTINCT a FROM table1) t;
執行計劃變為 Extra=Using index for group-by,利用派生表觸發 Loose Index Scan。
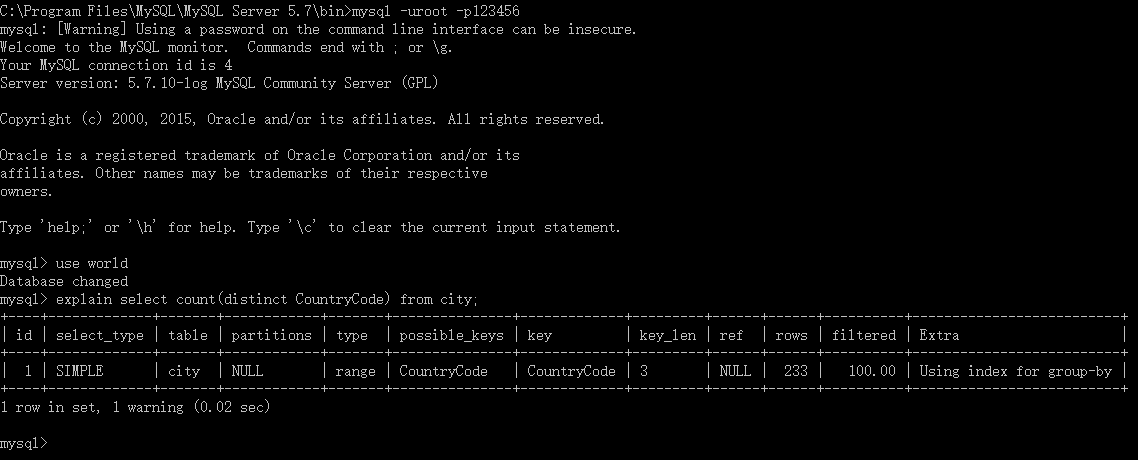
無需手工改寫,優化器自動識別COUNT(DISTINCT col)/GROUP BY col+MIN/MAX等模式,直接在索引上跳躍掃描,跳過重復鍵值頁面。
| 維度 | 普通掃描 (Tight Index Scan) | Loose Index Scan |
|---|---|---|
| 掃描範圍 | 所有滿足 WHERE 的索引條目 | 僅各組首條記錄,跳過重復鍵 |
| 臨時表 | 通常需要 | 不需要 |
| filesort | 通常需要 | 不需要 |
| Extra 顯示 | Using index / Using temporary; Using filesort | Using index for group-by |
| 適用聚合 | 任意 | MIN、MAX、COUNT(DISTINCT)、SUM(DISTINCT)、AVG(DISTINCT) |
Extra 確認是否觸發Loose Index Scan 是 MySQL 優化器針對「有序索引 + 分組聚合」的經典優化,理解其觸發條件,能讓你在設計索引、編寫報表 SQL 時事半功倍。