理解 SELECT 語句的子句解析順序與執行流程,是編寫高效 SQL、診斷效能問題的基礎。本文基於 MariaDB 架構,系統梳理查詢流程圖、子句邏輯順序、關鍵優化節點、緩存機制、連接類型、子查詢處理與聯合查詢,並提供實戰範例與 EXPLAIN 分析指引。
FROM (過濾表)
  → WHERE (過濾行)
  → GROUP BY (分組)
  → HAVING (分組過濾)
  → SELECT (選取欄位/投影)
  → ORDER BY (排序)
  → LIMIT (結果限制)
  → 最終結果集
關鍵洞察:WHERE 不能使用 SELECT 別名(尚未投影),HAVING 可使用聚合別名(已分組計算),ORDER BY/LIMIT 在最後處理。
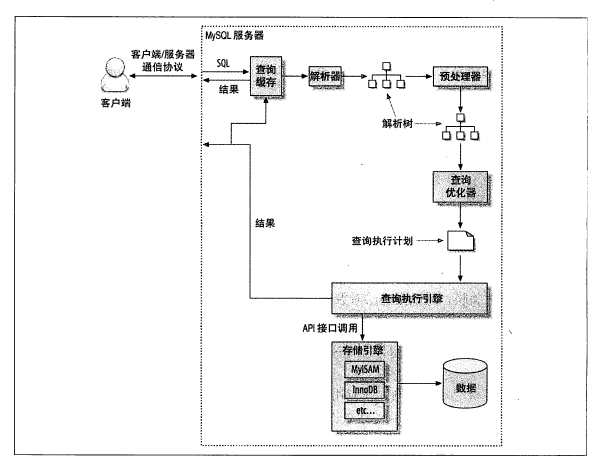
query_cache_type、query_cache_size(MySQL 8.0 已移除)| 類別 | 運算符/語法 | 範例 |
|---|---|---|
| 算術 | +, -, *, /, % | age/2=11 |
| 比較 | =, !=, <>, <=>, >, >=, <, <= | score >= 60 |
| 範圍 | BETWEEN min AND max | age BETWEEN 18 AND 60 |
| 集合 | IN (v1,v2,...), NOT IN | status IN (1,2,3) |
| 空值 | IS NULL, IS NOT NULL | deleted_at IS NULL |
| 模糊 | LIKE %/_ , RLIKE/REGEXP | name LIKE 'Zhang%' |
| 邏輯 | AND, OR, NOT | active=1 AND (role=1 OR role=2) |
-- 混合排序
SELECT name, age FROM students ORDER BY age DESC, name ASC;

-- 配合 LIMIT 分頁
SELECT name, age FROM students ORDER BY age LIMIT 10 OFFSET 10;  -- 第 2 頁,每頁 10 條
SHOW GLOBAL VARIABLES LIKE 'query_cache%';
-- query_cache_type = ON/DEMAND/OFF
-- query_cache_size > 0 才生效

-- 顯式控制
SELECT SQL_CACHE * FROM students WHERE id = 1;      -- DEMAND 模式下緩存
SELECT SQL_NO_CACHE * FROM students WHERE id = 1;   -- 強制不緩存

-- 不緩存場景:含 NOW()/RAND()/UUID()、用戶自定義函數、大結果集
| 連接類型 | 語法 | 語義 | 效能特徵 |
|---|---|---|---|
| 交叉連接 | CROSS JOIN / FROM t1, t2 | 笛卡爾積 | 極高消耗,嚴禁無條件使用 |
| 內連接 | INNER JOIN / JOIN | 匹配行 | 優化器可自由調整順序 |
| 等值連接 | ON t1.col = t2.col | 最常見內連接 | 利用索引高效 |
| 左外連接 | LEFT JOIN / LEFT OUTER JOIN | 左表全保留 | 左表驅動,右表無匹配填 NULL |
| 右外連接 | RIGHT JOIN | 右表全保留 | 等價 LEFT JOIN 交換順序 |
| 自然連接 | NATURAL JOIN | 同名欄位隱式匹配 | 不可控,生產禁用 |
| 自連接 | 表別名區分 | 同表不同角色 | 遞歸結構、層級查詢 |
欄位 核心含義 優化方向 type 連接類型:system > const > eq_ref > ref > range > index > ALL 避免 ALL,追求 ref/eq_ref possible_keys 可能用到的索引 無索引 → 建立索引 key 實際使用索引 未用 → 強制索引/重寫 rows 預估掃描行數 越小越好,統計信息準確性關鍵 Extra Using index/where/temporary/filesort 消除 temporary/filesort 九、總結
SELECT 執行流程遵循邏輯解析順序,優化器在物理執行層面進行深度重排。掌握子句語義順序、連接類型特徵、子查詢優化邊界、EXPLAIN 核心指標,是 SQL 調優的「內功心法」。建議:寫 SQL 前先想 EXPLAIN、上線前必跑 EXPLAIN ANALYZE、慢查詢必看 EXPLAIN,建立以執行計畫為中心的開發審查文化。