WHERE 條件書寫順序對查詢效能無實質影響(CBO/RBO 模式皆然)。優化器會根據統計資訊、索引、連接順序自動決定最佳存取路徑,而非按書寫順序執行。
-- 語句 1:右側除零,左側 1=2 為假
SELECT 'ok' FROM DUAL WHERE 1/0 = 1 AND 1 = 2;  -- 不報錯,回傳無資料

-- 語句 2:左側 1=2 為假,右側除零
SELECT 'ok' FROM DUAL WHERE 1 = 2 AND 1/0 = 1; -- ORA-01476: divisor is equal to zero現象:語句 1 不報錯,語句 2 報錯。
解釋:Oracle **語法解析/語意檢查** 確實從右到左(或特定順序),但**執行計畫生成後**,執行引擎會根據邏輯短路優化:1=2 為假 → 整個 AND 為假 → **不執行右側運算**。語句 2 解析階段先檢查右側除零合法性才報錯。這證明解析順序不等於執行順序。
DROP TABLE temp;
CREATE TABLE temp(t1 VARCHAR2(10), t2 VARCHAR2(10));
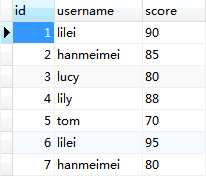
INSERT INTO temp VALUES('zm','abcde');
INSERT INTO temp VALUES('sz','1');
INSERT INTO temp VALUES('sz','2');
COMMIT;

-- 查詢 1:右側轉數字,左側 t1='sz'
SELECT * FROM temp WHERE TO_NUMBER(t2) > 1 AND t1 = 'sz';  -- 9i 不報錯,10g+ 不報錯

-- 查詢 2:左側 t1='sz',右側轉數字
SELECT * FROM temp WHERE t1 = 'sz' AND TO_NUMBER(t2) > 1;  -- 9i 報錯 "invalid number", 10g+ 不報錯
9i 行為:按書寫順序執行,查詢 2 先過濾 t1='sz' 得到 'abcde'、'1'、'2',再轉數字導致 'abcde' 報錯。
10g+ 行為:優化器自動重排,先執行 TO_NUMBER(t2) > 1 過濾掉 'abcde',再應用 t1='sz',**不報錯**。
結論:現代優化器(10g+)會**自動調整謂詞評估順序**以避免錯誤、提升效能,書寫順序無關。
CREATE OR REPLACE FUNCTION F1(v_IN VARCHAR2) RETURN VARCHAR2 IS
BEGIN DBMS_OUTPUT.PUT_LINE('exec F1'); RETURN v_IN; END;
/
CREATE OR REPLACE FUNCTION F2(v_IN VARCHAR2) RETURN VARCHAR2 IS
BEGIN DBMS_OUTPUT.PUT_LINE('exec F2'); RETURN v_IN; END;
/

SET SERVEROUTPUT ON;
SELECT 1 FROM DUAL WHERE F1('1')='1' AND F2('1')='1';
-- 輸出: exec F2 然後 exec F1  (從右到左)

SELECT 1 FROM DUAL WHERE F2('1')='1' AND F1('1')='1';
-- 輸出: exec F1 然後 exec F2 (從右到左)現象:函數確實從右到左執行。
關鍵點:這是**簡單邏輯表達式的短路評估順序**,不代表複雜查詢的資料存取路徑順序。優化器對複雜查詢會重構執行計畫,而非機械按書寫順序逐行過濾。
SELECT COUNT(*) FROM 診療項目目錄 WHERE 操作類型='1';  -- 3251 行
SELECT COUNT(*) FROM 診療項目目錄 WHERE 類別='Z';      -- 170 行
SELECT COUNT(*) FROM 診療項目目錄 WHERE 類別='Z' AND 操作類型='1';  -- 1 行

-- PL/SQL 循環 1000 次測試
BEGIN
  FOR i IN 1..1000 LOOP
    SELECT 名稱 INTO v1 FROM 診療項目目錄 WHERE 操作類型='1' AND 類別='Z';
  END LOOP;
END;
/
-- 交換條件順序再測 1000 次| 測試輪 | 操作類型在右 (類別在左) | 類別在右 (操作類型在左) |
|---|---|---|
| 1 | 0.093 秒 | 1.014 秒 |
| 2 | 1.06 秒 | 0.999 秒 |
| 3 | 0.998 秒 | 1.014 秒 |
分析:三輪結果波動大、無固定模式,證明**條件順序不影響效能**。
原理:無索引時皆為**全表掃描**,每塊資料讀入記憶體後,**同時檢查所有條件**(向量化評估),不存在「先過濾 170 行再過濾 3251 行」的流水線過程。
條件書寫順序**不在**優化器決策輸入中。
-- MySQL 8.0 測試
CREATE TABLE t (a INT, b INT, KEY idx_a(a), KEY idx_b(b));
INSERT INTO t SELECT 1, 1 UNION ALL SELECT 1, 2 UNION ALL SELECT 2, 1; -- 3 行

EXPLAIN SELECT * FROM t WHERE a=1 AND b=1;
EXPLAIN SELECT * FROM t WHERE b=1 AND a=1;
兩條 EXPLAIN 輸出**完全相同**:type=ref、key=idx_a (或 idx_b)、rows=1、Extra=Using where。優化器自動選擇最佳索引,忽略書寫順序。
RBO 模式下**(Oracle 10g 前預設),**FROM 子句表順序**影響連接順序:右側表作外層迴圈(驅動表),建議大表在左、小表在右。
CBO 模式**下,優化器自動根據統計資訊決定連接順序,表書寫順序無影響。
MySQL** 同樣:優化器自動決定驅動表(通常選擇過濾後行數最少的表),可用 STRAIGHT_JOIN 強制順序。
WHERE tenant_id=1 AND status=1 AND created_at > ...)。ANALYZE TABLE/DBMS_STATS),而非微調條件順序。WHERE varchar_col = 123 → WHERE varchar_col = '123',消除函數評估順序風險。WHERE (A=1 OR B=2) AND C=3,提升可讀性並輔助優化器。從 Oracle 9i 到 19c、MySQL 5.1 到 8.0,**WHERE 條件書寫順序從未是效能調優手段**。早期 RBO 時代的「條件順序論」已被 CBO 徹底淘汰。現代優化器基於成本模型、統計資訊、索引元數據自動生成最佳執行計畫。開發者應專注於**索引設計、統計資訊維護、SQL 改寫(消除函數操作、OR 改 UNION、子查詢改 JOIN)**、而非條件排列組合。工欲善其事,必先利其器:EXPLAIN、OPTIMIZER_TRACE、DBMS_XPLAN 才是洞察執行計畫的真正利器。