理解 MySQL 三層邏輯架構——連接管理層、SQL 處理層 (Server Layer)、存儲引擎層——是掌握查詢優化、故障診斷與架構設計的基石。本文結合官方架構圖,逐層拆解核心組件職責與交互流程。
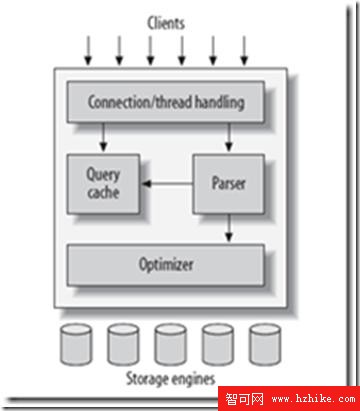
圖 1-1 MySQL 邏輯架構圖
thread_cache_size) 減少創建銷毀開銷。未來版本計劃解耦連接與線程支援更高併發。User、Host、Password、SSL/X.509 綜合驗證。連接建立後,每條 SQL 執行前均做權限檢查 (全局 → 庫 → 表 → 列 → 程序)。--compress)、SSL 加密、管道/共享內存 (Windows)。MySQL 核心大腦,所有存儲引擎共享此層功能:
解析前檢查 SELECT 文本完全匹配 (Byte-by-byte),命中直接返回結果集,跳過解析/優化/執行。失效粒度為表級,任何寫入導致相關快取失效。8.0 移除原因:鎖競爭嚴重、命中率低、不支援並行查詢。
基於成本模型 (Cost Model) 選擇最優執行計畫:
optimizer_search_depth 控制深度。ANALYZE TABLE 更新索引基數、直方圖 (8.0+),優化器據此估算行數與選擇度。Hint 干預:USE INDEX/IGNORE INDEX/FORCE INDEX、STRAIGHT_JOIN、MAX_EXECUTION_TIME。
Created_tmp_tables):內存 (tmp_table_size/max_heap_table_size) 或磁碟 (MyISAM/InnoDB)。net_buffer_length → max_allowed_packet)。日期/時間、數學、加密、字串、JSON、GIS、窗口函數 (8.0+) 等;存儲過程、觸發器、視圖、CTE、準備語句 均在 Server Layer 實現,引擎無感。
負責數據的物理存儲、索引維護、事務管理、鎖控制、恢復機制。Server 通過統一 Handler API 與引擎交互,屏蔽實現差異。
| 特性 | InnoDB (預設) | MyISAM | Memory | NDB Cluster |
|---|---|---|---|---|
| 事務/ACID | ✅ 支援 | ❌ | ❌ | ✅ 分佈式 |
| 鎖粒度 | 行鎖 + 間隙鎖 | 表鎖 | 表鎖 | 行鎖 |
| MVCC | ✅ | ❌ | ❌ | ✅ |
| 外鍵 | ✅ | ❌ | ❌ | ❌ |
| 全文索引 | 5.6+ ✅ | ✅ | ❌ | ❌ |
| 壓縮 | 頁面壓縮/透明壓縮 | ✅ (myisampack) | ❌ | ✅ |
| 崩潰恢復 | Redo/Undo Log | ❌ (需 REPAIR) | 數據丟失 | Checkpoint |
| 適用場景 | OLTP、高併發、關鍵業務 | 只讀/日誌/全文 | 臨時計算/查找表 | 高可用/分佈式 |
ha_open_record()      -- 打開表
ha_index_init()       -- 初始化索引讀取
ha_index_read_map()   -- 索引查找 (等於/範圍)
ha_rnd_next()         -- 全表掃描下一行
ha_write_row()        -- 插入行
ha_update_row()       -- 更新行
ha_delete_row()       -- 刪除行
ha_commit_trans()     -- 提交事務
ha_rollback_trans()   -- 回滾事務
引擎不解析 SQL (除 InnoDB 解析外鍵定義),不直接互通,僅響應 Server 請求,實現「查詢與存儲解耦」。
records_in_range()、index_flags()、table_flags() 估算成本index_read → rnd_next 取行 → 過濾/投影透徹理解三層架構,才能在 SQL 調優、引擎選型、故障定位、架構演進中做出正確決策。建議配合 PERFORMANCE_SCHEMA、sys schema 觀測各層延遲與瓶頸。