近期公司一個基於 PHP+MySQL 架構的專案,主表記錄量約 150 萬條。為了搜索引擎收錄,針對 SEO 做了專門優化:搜索「山東+公司」時,關鍵字組合為「山東,公司,山東公司」,標題同步相關。用戶首次搜索生成關鍵字記錄,後續搜索僅增加計數,並製作關鍵字 sitemap 優化,搜索結果每頁顯示 80 條。
運行一段時間後發現,許多熱門關鍵字(如「五金」)擁有 9 萬多條記錄。當用戶翻頁至第 1000 頁(即第 8 萬條記錄)時,查詢耗時高達 10 秒,導致客戶投訴速度慢。
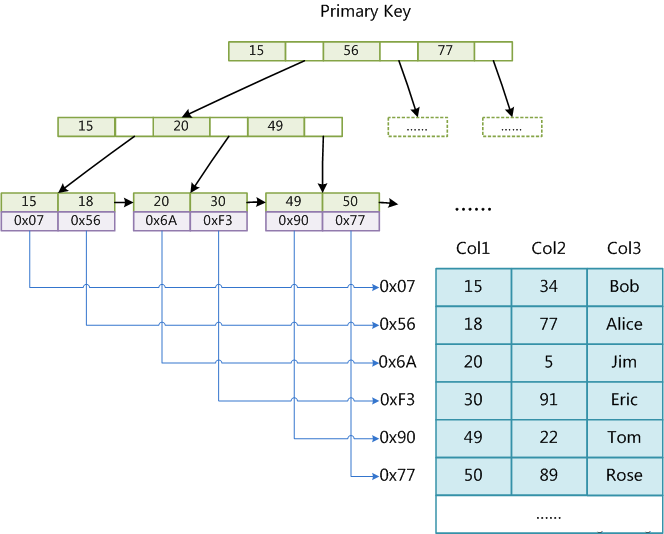
首先為常用篩選字段(所在城市、所在省份、公司 ID、所屬行業)建立索引,企業目錄查詢即使定位到第 8 萬條記錄,也能控制在 1 秒內。但關鍵字模糊查詢(LIKE 查詢無索引字段)速度仍未解決。
原 SQL 為:select * from st_company {where} order by coid asc
靈感來自 MySQL 的 IN 語法。將查詢拆分為兩步:
select co_id from st_company {where} order by coid ascselect * from st_company where co_id in (1,2,3,4,5,6)此法將查詢速度提升約 10 倍。即使在第 8 萬條數據使用 LIKE 查詢無索引字段,耗時也不超過 1 秒,效果顯著。
減少查詢字段提升了速度,是否跳過前段記錄能更快?MySQL 無 TOP 語法,只能用 LIMIT,深分頁性能必然下降。
參考主流搜索引擎處理深分頁策略:
結論:實際搜索無需返回過多結果。最終決定僅返回 1600 條記錄(20 頁),SQL 查詢時間穩定在 0.05-0.2 秒。用戶若前 10 頁未找到目標,大概率會更換關鍵詞。
本文記錄了從索引建立、兩階段查詢到分頁截斷的完整優化路徑,希望為從事 Tag 優化、大數據搜索的同行提供參考。核心心法:減少掃描行數、避免深分頁、利用覆蓋索引、業務層面合理截斷結果集。