MySQL 提供 REPLACE 字符串替換函數與 REGEXP 正則表達式匹配,是數據清洗、模糊搜索、文本處理的利器。本文系統整理語法、實戰案例、中文編碼陷阱與性能優化建議。
REPLACE INTO table (id, name) VALUES ('1', 'aa'), ('2', 'bb');邏輯:若主鍵/唯一鍵衝突 → 刪除舊行 → 插入新行。等效於 DELETE + INSERT。
⚠ 需表有主鍵或唯一索引,否則退化為普通 INSERT。
SELECT REPLACE('www.163.com', 'w', 'Ww');  -- 返回 'WwWwWw.163.com'

-- 批量更新表字段
UPDATE `table` SET `name` = REPLACE(`name`, 'aa', 'bb');
將字段中所有 aa 替換為 bb,區分大小寫。
| 符號 | 含義 | 示例匹配 |
|---|---|---|
^ | 字符串開始 | '^abc' 匹配以 abc 開頭 |
$ | 字符串結束 | 'xyz$' 匹配以 xyz 結尾 |
. | 任意單字符(含換行) | 'a.c' 匹配 abc、axc |
[...] | 字符類,任一字符 | '[abc]' 匹配 a/b/c |
[^...] | 排除字符類 | '[^0-9]' 匹配非數字 |
* | 前字符 0 次或多次 | 'ab*c' 匹配 ac、abc、abbc |
+ | 前字符 1 次或多次 | 'ab+c' 匹配 abc、abbc |
? | 前字符 0 次或 1 次 | 'ab?c' 匹配 ac、abc |
{n} | 前字符恰好 n 次 | 'a{3}' 匹配 aaa |
{n,} | 前字符至少 n 次 | 'a{2,}' 匹配 aa、aaa... |
{n,m} | 前字符 n 到 m 次 | 'a{2,4}' 匹配 aa、aaa、aaaa |
| | 或關係 | 'cat|dog' 匹配 cat 或 dog |
(...) | 分組 | '(ab)+' 匹配 ab、abab |
| 語法 | 等價於 | 說明 |
|---|---|---|
[:alnum:] | [A-Za-z0-9] | 字母數字 |
[:alpha:] | [A-Za-z] | 字母 |
[:digit:] | [0-9] | 數字 |
[:lower:] | [a-z] | 小寫字母 |
[:upper:] | [A-Z] | 大寫字母 |
[:space:] | [ \t\r\n\v\f] | 空白字符 |
[:punct:] | 標點符號 | |
[:xdigit:] | [0-9A-Fa-f] | 十六進制 |
[[:<:]]:單詞開頭[[:>:]]:單詞結尾SELECT 'a word a' REGEXP '[[:<:]]word[[:>:]]'; -- 1 (匹配)
SELECT 'a xword a' REGEXP '[[:<:]]word[[:>:]]'; -- 0 (不匹配)-- 以 b 開頭
SELECT * FROM pet WHERE name REGEXP '^b';
-- 以 fy 結尾
SELECT * FROM pet WHERE name REGEXP 'fy$';
-- 包含 w
SELECT * FROM pet WHERE name REGEXP 'w';
-- 精確 5 字符
SELECT * FROM pet WHERE name REGEXP '^.....$';
-- 或
SELECT * FROM pet WHERE name REGEXP '^.{5}$';SELECT * FROM contact WHERE name LIKE '%a%';
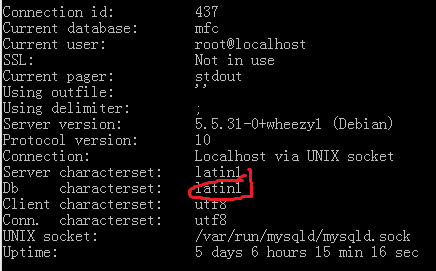
-- 結果竟包含中文「新」!MySQL 默認字符集 latin1/utf8 且 不區分大小寫,中文 UTF-8 編碼中某些字節恰好落在 ASCII 字母範圍,導致大小寫轉換邏輯誤判。
| 方案 | SQL 示例 | 優點 | 缺點 |
|---|---|---|---|
| 字段加 BINARY | name CHAR(10) BINARY | 表級生效,無需改 SQL | 區分大小寫,插入也受影響 |
| 編譯指定 charset=gbk | ./configure --with-charset=gbk | 原生支持中文排序 | 需重編譯,遷移麻煩 |
| LOCATE 函數 | WHERE LOCATE('a', name) > 0 | 不改表結構 | 同樣不區分大小寫 |
| LIKE BINARY | WHERE name LIKE BINARY '%a%' | 單次查詢生效 | 區分大小寫 |
| UCASE/BINARY 組合(推薦) | WHERE BINARY UCASE(name) LIKE UCASE('%a%') | 不區分大小寫、正確匹配中文 | 略慢(函數導致全表掃描) |
-- 不區分大小寫、正確處理中文
SELECT id, title FROM news
WHERE BINARY UCASE(title) LIKE CONCAT('%', UCASE('搜索詞'), '%');正則中使用字面量特殊字符需雙反斜杠:
SELECT '1+2' REGEXP '1\\+2';  -- 1 (匹配)
SELECT '1+2' REGEXP '1+2';    -- 0 (+ 被視為元字符)
SELECT '1+2' REGEXP '1\+2'; -- 0 (單反斜杠被 SQL 消費)LIKE '%abc' / REGEXP 'abc' 導致全表掃描LIKE 'abc%' 可用索引FULLTEXT,配合 MATCH...AGAINST總結:
REPLACE適合精確替換;REGEXP功能強但性能弱;中文模糊查詢用BINARY UCASE(...)組合;大規模搜索上專業搜索引擎。