慢查詢是效能殺手,系統化處理流程:
[mysqld]
slow_query_log = ON
slow_query_log_file = /var/log/mysql/mysql-slow.log
long_query_time = 1          # 超過 1 秒記錄 (微秒級精度)
log_queries_not_using_indexes = ON  # 記錄未用索引查詢 (慎用,量大)
# log_slow_admin_statements = ON    # 記錄管理語句
# log_slow_slave_statements = ON    # 記錄從庫重放慢查詢
重啟或動態生效:SET GLOBAL slow_query_log=ON; SET GLOBAL long_query_time=1;
# 即時追蹤
tail -f /var/log/mysql/mysql-slow.log

# 專業分析工具:pt-query-digest (Percona Toolkit)
pt-query-digest /var/log/mysql/mysql-slow.log --limit 20 --since "2 hours ago"
# 輸出:Top N 查詢、總耗時、平均耗時、掃描行數、QPS、指紋
# 從慢查詢日誌提取 SQL
EXPLAIN SELECT * FROM some_table WHERE some_col = 'value';
-- 關注:
-- type=ALL (全掃) → 需加索引
-- key=NULL (未用索引) → 檢查 possible_keys
-- rows 巨大 → 索引選擇性低或條件不當
-- Extra=Using filesort/temporary → 優化 ORDER BY/GROUP BY 索引
-- 慢查詢掃描 166 行全表
EXPLAIN SELECT * FROM some_table WHERE some_col = 'value';
-- type=ALL, key=NULL, rows=166

-- 加索引
CREATE INDEX idx_some_col ON some_table(some_col);

-- 再次分析
EXPLAIN SELECT * FROM some_table WHERE some_col = 'value';
-- type=ref, key=idx_some_col, rows=1 (或少量)
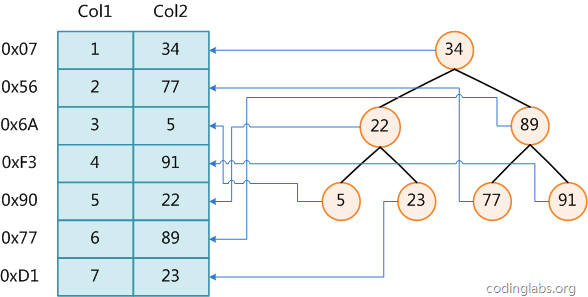
以下查詢掃描全庫統計資訊,找出 基數/行數 < 1% 的非唯一索引 (選擇性極低,優化器傾向不走):
SELECT
  t.TABLE_SCHEMA AS `db`,
  t.TABLE_NAME AS `table`,
  s.INDEX_NAME AS `index_name`,
  s.COLUMN_NAME AS `column_name`,
  s.SEQ_IN_INDEX AS `seq_in_index`,
  s2.max_columns AS `#_cols`,
  s.CARDINALITY AS `cardinality`,
  t.TABLE_ROWS AS `est_rows`,
  ROUND(((s.CARDINALITY / IFNULL(t.TABLE_ROWS, 0.01)) * 100), 2) AS `sel_%`
FROM INFORMATION_SCHEMA.STATISTICS s
INNER JOIN INFORMATION_SCHEMA.TABLES t
  ON s.TABLE_SCHEMA = t.TABLE_SCHEMA AND s.TABLE_NAME = t.TABLE_NAME
INNER JOIN (
  SELECT TABLE_SCHEMA, TABLE_NAME, INDEX_NAME, MAX(SEQ_IN_INDEX) AS max_columns
  FROM INFORMATION_SCHEMA.STATISTICS
  WHERE TABLE_SCHEMA != 'mysql'
  GROUP BY TABLE_SCHEMA, TABLE_NAME, INDEX_NAME
) s2 ON s.TABLE_SCHEMA = s2.TABLE_SCHEMA AND s.TABLE_NAME = s2.TABLE_NAME AND s.INDEX_NAME = s2.INDEX_NAME
WHERE t.TABLE_SCHEMA != 'mysql'
  AND t.TABLE_ROWS > 10
  AND s.CARDINALITY IS NOT NULL
  AND (s.CARDINALITY / IFNULL(t.TABLE_ROWS, 0.01)) < 1.00
ORDER BY `sel_%`, s.TABLE_SCHEMA, s.TABLE_NAME
LIMIT 20;
sel_% < 1%:索引幾乎不分流資料,優化器會忽略走全掃。DROP INDEX 節省寫入開銷。EXPLAIN 確認 type、rows、Extra 改善。pt-query-digest 定期報告,追蹤慢查詢趨勢。long_query_time 突增、Rows_examined 異常增長。