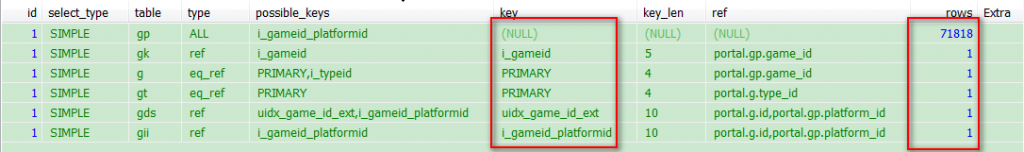
t_innodb_random (InnoDB, 無顯式主鍵, id 有索引)EXPLAIN SELECT id FROM t_innodb_random WHERE id = 13412; -- type=ref, rows=1, 0.00 秒
SELECT id FROM t_innodb_random WHERE id = ROUND(RAND()*13241324);
-- type=index, rows=393345, 0.26 秒
RAND() 視為變量,無法走等值查詢。
SELECT id FROM t_innodb_random
WHERE id = ROUND(RAND() * (SELECT MAX(id) FROM t_innodb_random));
-- type=index, rows=393345, 0.27 秒
SELECT id FROM t_innodb_random
WHERE id = (SELECT ROUND(RAND() * (SELECT MAX(id) FROM t_innodb_random)) AS nid);
-- type=index, rows=393345, 0.27 秒
SELECT id FROM t_innodb_random t1
JOIN (SELECT ROUND(RAND()*13241324) AS id2) t2 ON t1.id = t2.id2;
-- t1: type=ref, rows=1, 0.00 秒!
原理:衍生表 t2 先執行產生常量,JOIN 變為常量等值查詢。
SELECT id FROM t_innodb_random
WHERE id > (SELECT ROUND(RAND() * (SELECT MAX(id) FROM t_innodb_random)) AS nid)
LIMIT 1;
-- type=index, rows=393345, 但 LIMIT 1 早期終止,0.00 秒
SELECT id FROM t_innodb_random ORDER BY RAND() LIMIT 1000;
-- Using temporary; Using filesort, 0.41 秒
SELECT id FROM t_innodb_random
WHERE id > (SELECT RAND() * (SELECT MAX(id) FROM t_innodb_random) AS nid)
LIMIT 1000;
-- 0.04 秒
SELECT id FROM t_innodb_random t1
JOIN (SELECT RAND() * (SELECT MAX(id) FROM t_innodb_random) AS nid) t2
  ON t1.id > t2.nid
LIMIT 1000;
-- t1: type=range, rows=196672, 0.00 秒!
-- 隨機取 1 行
SELECT * FROM tbl t1
JOIN (SELECT RAND() * (SELECT MAX(id) FROM tbl) AS nid) t2
  ON t1.id >= t2.nid
ORDER BY t1.id LIMIT 1;

-- 隨機取 N 行
SELECT * FROM tbl t1
JOIN (SELECT RAND() * (SELECT MAX(id) FROM tbl) AS nid) t2
  ON t1.id > t2.nid
LIMIT N;
| 條件 | 說明 |
|---|---|
| 有數值型主鍵/唯一鍵 | id 必須可排序、可範圍查詢 |
| 數據分佈相對均勻 | 極度傾斜會導致分布不均 |
| 允許「非嚴格隨機」 | 基於 id 空間隨機,非行級等概率 |
| 無大量刪除產生空洞 | 空洞大會降低命中率 |
-- 方案一:預計算隨機排序列
ALTER TABLE tbl ADD rand_sort DOUBLE;
UPDATE tbl SET rand_sort = RAND();
CREATE INDEX idx_rand ON tbl(rand_sort);
-- 查詢:ORDER BY rand_sort LIMIT N  (需定期重算)

-- 方案二:應用層隨機 ID 列表
-- 1. SELECT id FROM tbl
-- 2. 應用層隨機抽樣 N 個 ID
-- 3. SELECT * FROM tbl WHERE id IN (...)
ORDER BY RAND() 是性能殺手。利用 JOIN 衍生表將 RAND() 降維為常量,配合範圍查詢 + LIMIT,可將隨機查詢從秒級優化至毫秒級。業務若要求嚴格等概率,建議應用層抽樣或預計算隨機列。