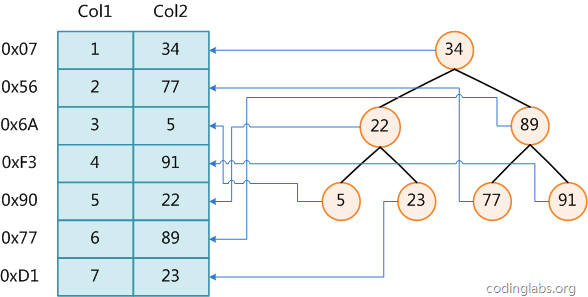
索引提升查詢效率、降低 I/O、降低排序成本(CPU/記憶體),但寫入時需維護索引結構(B+ 樹分裂合併),佔用儲存空間。決策核心:查詢收益 > 維護成本。
INDEX (a,b,c) 可服務 WHERE a=1 AND b=2、ORDER BY a,b、SELECT a,b,cCardinality / Rows < 0.01 視為低基數INDEX (user_id, status))last_login_time、view_count、balance 高頻更新,通常不建單列索引description、remark、avatar_url)| 場景 | 建議 | 理由 |
|---|---|---|
| 主鍵/唯一鍵 | 必建 | InnoDB 聚簇索引/二級索引基石 |
| 外鍵欄位 | 必建 | 避免 FK 檢查鎖表掃描 |
| 範圍查詢欄位 | 建組合索引末位 | 範圍列後的列無法用到索引 |
| 排序/分組欄位 | 建索引避免 filesort | 索引天然有序 |
| 全文搜尋 | FULLTEXT 索引 | 專用倒排索引 |
| JSON 欄位查詢 | 虛擬欄位 + 索引 (5.7+) | 避免全表掃描 JSON_EXTRACT |
EXPLAIN SELECT * FROM orders WHERE user_id=123 AND status=1;
-- key: idx_user_status, type: ref, rows: 10 → 索引生效
-- type: ALL, rows: 1000000 → 全表掃描,索引失效

SHOW INDEX FROM orders;
-- Cardinality 接近 Rows 為高選擇性
ANALYZE TABLE 更新統計資訊(InnoDB 自動統計通常足夠)pt-duplicate-key-checker 檢測重複/冗餘索引pt-index-usage 分析慢查詢日誌找出未用索引DROP INDEX idx_x ON tbl索引不是越多越好。核心四問:高頻查詢條件?高基數?低頻更新?確實會被用到? 全部是 → 建;有一個否 → 重新評估。組合索引遵循最左前綴、區分度高的前置、範圍列最後。定期清理無用索引,讓寫入輕裝上陣。