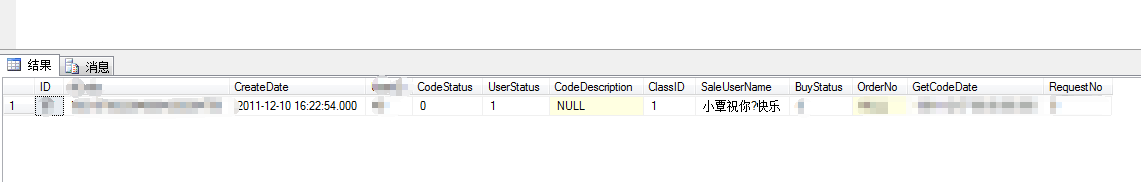
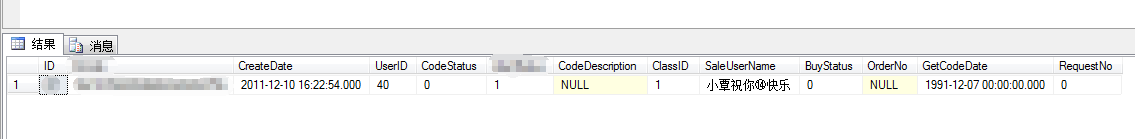
嘗試在 VARCHAR(50) 字段存儲包含特殊 Unicode 字符(如 🎵 U+1F3B5)的字符串:
UPDATE TableName SET saleUserName='小覃祝你🎵快樂' WHERE ID=87;
SELECT * FROM TableName WHERE ID=87;
結果:特殊字符變為亂碼或問號。將字段改為 NVARCHAR(50) 後直接插入,問題依舊。只有在字符串前加上 N 前綴 才正確存儲:
UPDATE TableName SET saleUserName=N'小覃祝你🎵快樂' WHERE ID=87;
| 特性 | VARCHAR | NVARCHAR |
|---|---|---|
| 存儲編碼 | 字符集決定(如 utf8mb4、gbk、latin1) | 固定為 UTF-16(UCS-2) |
| 字節存儲 | 變長,1-4 字節/字符(取決於字符集) | 固定 2 字節/字符(補充字符用 4 字節) |
| 最大長度 | 65,535 字節(共享行大小限制) | 4,000 字符(8,000 字節) |
| MySQL 實現 | 原生支持 | MySQL 無 NVARCHAR 類型,僅 SQL Server 有 |
關鍵發現:原文提到的 NVARCHAR 實為 SQL Server 語法。MySQL 中對應的是 VARCHAR CHARACTER SET utf8mb4 或 CHARACTER SET ucs2。
在 SQL Server 中:
N'...' 前綴:強制按 Unicode (UTF-16) 編碼發送,繞過字符集轉換層若默認字符集不支持該字符(如 GBK 無法表示 Emoji),無前綴插入必然丟失數據。
-- 建表指定 utf8mb4(支持完整 Unicode,含 Emoji)
CREATE TABLE t (
    name VARCHAR(50) CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci
) CHARACTER SET utf8mb4;

-- 或修改現有表
ALTER TABLE TableName MODIFY saleUserName VARCHAR(50) CHARACTER SET utf8mb4;
ALTER TABLE TableName CONVERT TO CHARACTER SET utf8mb4;
注意:MySQL 的 utf8 別名實為 utf8mb3,僅支持 BMP 平面(3 字節),無法存儲 Emoji 等補充字符,必須顯式指定 utf8mb4。
客戶端、連接、結果集字符集必須統一:
-- 連接時指定
mysql -u root -p --default-character-set=utf8mb4

-- 或代碼中設置(Python 示例)
conn = pymysql.connect(charset='utf8mb4')

-- 會話級設置
SET NAMES utf8mb4;
-- 等價於
SET character_set_client = utf8mb4;
SET character_set_connection = utf8mb4;
SET character_set_results = utf8mb4;
-- 插入測試
INSERT INTO t(name) VALUES ('測試🎵Emoji');

-- 檢查十六進制存儲
SELECT HEX(name) FROM t WHERE name LIKE '%🎵%';
-- utf8mb4 應輸出:E6B58BE8AF95F09F8EB5E4B880E5A4A7E5AD97 (測試🎵Emoji 的 UTF-8 編碼)
MySQL 只有 CHAR、VARCHAR、TEXT 系列,通過 CHARACTER SET 實現 Unicode 存儲。NCHAR/NVARCHAR 是 SQL Server/Oracle 的專有類型。
ALTER TABLE ... MODIFY 僅改變元數據,**不會轉換已存數據**。需用 CONVERT TO CHARACTER SET 重寫數據,或導出重導。
即使表是 utf8mb4,若連接用 latin1/gbk,插入時會按連接字符集編碼,導致「存入時正常、讀出亂碼」或「存入即截斷」。
utf8mb4,校對規則推薦 utf8mb4_unicode_ci(準確排序)或 utf8mb4_0900_ai_ci(MySQL 8.0+,性能更好)charset=utf8mb4_utf8mb4'字符串' 介紹符語法utf8 表遷移至 utf8mb4 需評估索引長度限制(InnoDB 767 字節 → 3072 字節,MySQL 5.7+ 默認開啟 innodb_large_prefix)MySQL 中正確存儲特殊 Unicode 字符的關鍵在於:**全鏈路 utf8mb4**,而非依賴不存在的 NVARCHAR 或 N 前綴。理解字符集在存儲層、傳輸層、應用層的交互機制,才能從根本上解決亂碼、截斷、索引失效等一系列「鬼畜」問題。