SELECT COUNT(DISTINCT id) FROM tablename;
SELECT DISTINCT id FROM tablename;
-- 實際行為:id 和 type 組合去重
SELECT DISTINCT id, type FROM tablename;
-- 等價於
SELECT id, type FROM tablename GROUP BY id, type;
誤區:以為只按 id 去重,實際是組合去重。
SELECT id, GROUP_CONCAT(DISTINCT type) FROM tablename GROUP BY id;
SELECT id, type, COUNT(DISTINCT id) FROM tablename GROUP BY id;
-- 或簡潔版
SELECT id, type FROM tablename GROUP BY id;
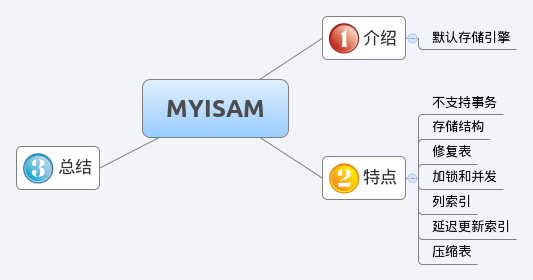
SELECT COUNT(*) FROM tablename; -- MyISAM 瞬間返回,InnoDB 掃描但有優化
SELECT COUNT(*) FROM tablename WHERE status=1; -- 需逐行檢查
| 引擎 | 無 WHERE | 有 WHERE | 原理 |
|---|---|---|---|
| MyISAM | O(1) 秒級 | 全表掃描 | 元數據存儲行數 |
| InnoDB | 全表掃描(MVCC 一致性讀) | 全表掃描 | 不存儲精確行數,需掃描聚簇索引 |
EXPLAIN SELECT COUNT(*) ... 觀察 rows 估算值WHERE 條件欄位建立索引,利用 Using index 避免回表-- 測試表 CREATE TABLE t_count (id INT PRIMARY KEY, val INT, KEY idx_val(val)) ENGINE=InnoDB; -- 插入 100 萬測試數據... -- 方案對比 SELECT COUNT(*) FROM t_count; -- 全表掃描 ~300ms SELECT COUNT(*) FROM t_count WHERE val > 500000; -- 索引範圍掃描 ~50ms SELECT COUNT(DISTINCT val) FROM t_count; -- 去重統計 ~200ms
核心結論:InnoDB 下 COUNT(*) 無捷徑,善用 WHERE+索引與計數表模式;DISTINCT 多欄位時明確語義,優先考慮 GROUP BY 替代。