MySQL 以高性能、低成本成為互聯網首選 RDBMS。但「好馬配好鞍」,讀寫比約 10:1 的典型業務中,**複雜查詢是效能殺手**。美團核心業務系統部積累上百個慢查詢案例,本文從索引底層原理出發,構建系統化優化方法論。
索引本質是通過不斷縮小範圍將隨機查找轉為順序查找。但資料庫面臨磁盤 I/O 瓶頸:
OS 預讀機制將相鄰數據一次性讀入內存頁(Page,通常 4KB/8KB),**索引結構設計目標:將查找過程中的磁盤 I/O 次數控制在常數級(樹高 h)。**
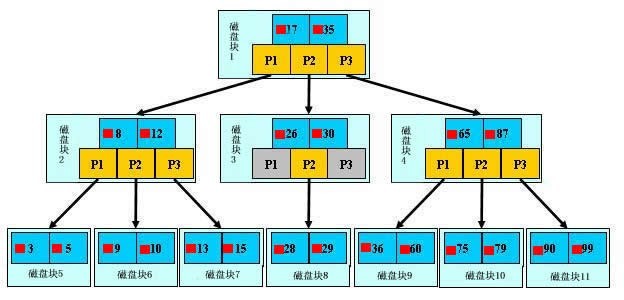
m = 頁大小 / 索引項大小,h = log(m+1)N。INT(4B) 優於 BIGINT(8B),字符串慎用長索引。(a,b,c) 按 a → b → c 順序建樹。查詢 WHERE a=1 AND b=2 可用索引;WHERE b=2 無法利用索引(缺少引導列 a)。>、<、LIKE、BETWEEN)停止匹配。a=1 AND b=2 AND c>3 AND d=4 建 (a,b,d,c) 可用到 d。= 和 IN 可亂序:優化器會自動重排。count(DISTINCT col)/count(*) 越大越好。JOIN 字段建議 > 0.1(平均 1 行掃 10 行)。from_unixtime(create_time) = '2014-05-29' ❌ → create_time = unix_timestamp('2014-05-29') ✅(a),需 (a,b) 直接 ALTER TABLE ... ADD INDEX (a,b) 覆蓋舊索引。SQL_NO_CACHE 確認真慢。rows,越小越快。ORDER BY LIMIT 讓排序表優先查。原 SQL:cm_log 關聯派生表(employee + emp_certificate),EXPLAIN 顯示派生表掃描 6.3 萬行,再與 379 行 cm_log 關聯,Using temporary; Using join buffer。
優化思路:將 OR 條件拆分為兩個 UNION 子查詢,提前關聯 cm_log 過濾,利用 UNION 天然去重替代 DISTINCT。
結果:1.87s → 10ms,**掃描行數從 6.3 萬降至 379+379**。
SQL:WHERE accurate_result=1 AND sync_status IN (0,2,4)
理論困境:兩列區分度極低(accurate_result 只有 -1/0/1,sync_status 99% 是 3),教科書說不該建索引。
業務實情:定時任務每 5 分鐘掃描,處理完將 sync_status 改為 1,**符合條件的行始終只有 ~1000 行,極度不平衡**。
實測:建立 idx_acc_status(accurate_result, sync_status),6.22s → 200ms,**30 倍提升**。
啟示:不了解業務場景,不敢動索引。
ORDER BY LIMIT 陷阱 —— 13000 倍提升後的隱患原 SQL:4 表 JOIN 後 ORDER BY c.created_time DESC LIMIT 10,13s。
EXPLAIN:驅動表 org_emp_info 掃 8849 行,最終排序前鎖定 77 萬行!
優化 1:改用 EXISTS 子查詢,先按 contact.created_time 索引排序取 Top 10 再 JOIN 過濾。13s → 1ms。
極端反例:修改參數導致內層無匹配行,MySQL 持續取 10 行再 JOIN 失敗,**近乎全表掃描,2 分 18 秒!**
結論:並非所有 SQL 都能優化;優化必須覆蓋極端參數,否則引入新災難。
任何資料庫層面優化都抵不上應用架構優化。同樣的 MySQL,能支撐 Google/Facebook,也可能撐不住個人站點。熟悉優化器、索引內核、執行計劃,是寫出高性能 SQL 的前提。