故障現場
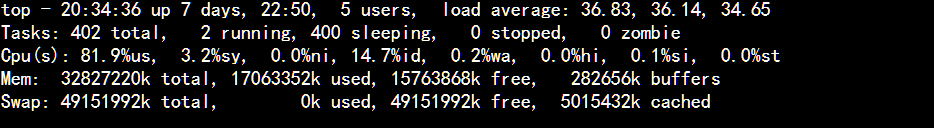
- 症狀: CPU 負載飆至 36,業務幾乎不可用
- 發現:
mysqladmin processlist 大量 Sending data 狀態
- 典型慢 SQL:
SELECT * FROM rep_corp_vehicle_online_count WHERE corp_id = 48 AND vehicle_id = 10017543
表結構與索引現狀
DESC rep_corp_vehicle_online_count;
+-------------+-------------+------+-----+---------+----------------+
| Field       | Type        | Null | Key | Default | Extra          |
+-------------+-------------+------+-----+---------+----------------+
| id          | int(11)     | NO   | PRI | NULL    | auto_increment |
| corp_id     | int(11)     | NO   |     | NULL    |                |
| vehicle_id  | int(11)     | NO   |     | NULL    |                |
| online_day  | varchar(20) | NO   |     | NULL    |                |
| loc_total   | int(11)     | NO   |     | NULL    |                |
| create_time | datetime    | NO   |     | NULL    |                |
| update_time | datetime    | NO   |     | NULL    |                |
+-------------+-------------+------+-----+---------+----------------+

SHOW INDEX FROM rep_corp_vehicle_online_count;
-- 僅有 PRIMARY KEY (id)
執行計劃分析
EXPLAIN SELECT * FROM rep_corp_vehicle_online_count
WHERE corp_id = 79 AND vehicle_id = 10016911 AND online_day = '2016-03-29'\G
*************************** 1. row ***************************
id: 1
select_type: SIMPLE
table: rep_corp_vehicle_online_count
type: ALL          -- 全表掃描!
possible_keys: NULL
key: NULL
key_len: NULL
ref: NULL
rows: 1248495      -- 掃描 124 萬行
Extra: Using where
資料分佈洞察
SELECT COUNT(DISTINCT corp_id) FROM rep_corp_vehicle_online_count;  -- 18
SELECT COUNT(corp_id) FROM rep_corp_vehicle_online_count;           -- 123 萬
SELECT COUNT(DISTINCT vehicle_id) FROM rep_corp_vehicle_online_count; -- 2580
SELECT COUNT(vehicle_id) FROM rep_corp_vehicle_online_count;        -- 123 萬
corp_id 僅 18 個不同值,但重複極高vehicle_id 2580 個不同值,區分度尚可- 組合
(corp_id, vehicle_id) 區分度極高,極適合建聯合索引
優化動作:建立聯合索引
CREATE INDEX r_c_v ON rep_corp_vehicle_online_count(corp_id, vehicle_id);
-- 耗時 6.09 秒,影響 148 萬行
優化後驗證
SHOW INDEX FROM rep_corp_vehicle_online_count;
+-------------------------------+------------+----------+--------------+-------------+-----------+
| Table                         | Non_unique | Key_name | Seq_in_index | Column_name | Cardinality |
+-------------------------------+------------+----------+--------------+-------------+-----------+
| rep_corp_vehicle_online_count | 0          | PRIMARY  | 1            | id          | 1490176   |
| rep_corp_vehicle_online_count | 1          | r_c_v    | 1            | corp_id     | 18        |
| rep_corp_vehicle_online_count | 1          | r_c_v    | 2            | vehicle_id  | 2596      |
+-------------------------------+------------+----------+--------------+-------------+-----------+
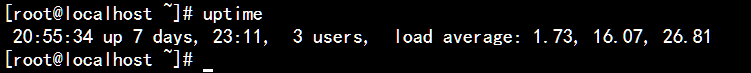
核心心法
- 慢 SQL 定位:
processlist + slow query log
- 執行計劃判斷:
type=ALL、rows 大、key=NULL → 缺索引
- 資料分佈決定索引列順序: 區分度高的靠左,
(corp_id, vehicle_id) 而非反序
- 覆蓋索引思維: 若只查特定列,可將其加入索引避免回表
- 索引維護成本: 寫入量大的表慎加索引,定期
ANALYZE TABLE 更新統計信息
一條精準的索引,勝過十台更強的伺服器。索引優化是 MySQL 效能調優 ROI 最高的動作。