INSERT INTO table (col1, col2, ...)
VALUES
  (v11, v12, ...),
  (v21, v22, ...),
  ...
  (vn1, vn2, ...);
CREATE TABLE authors (
  auth_id SMALLINT PRIMARY KEY,
  auth_fn VARCHAR(20),
  auth_mn VARCHAR(20),
  auth_ln VARCHAR(20)
) ENGINE=InnoDB;

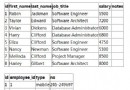
INSERT INTO authors VALUES
(1006, 'H', 'S.', 'T'),
(1007, 'J', 'C', 'O'),
(1008, 'B', NULL, 'E'),
(1009, 'R', 'M', 'R'),
(1010, 'J', 'K', 'T'),
(1011, 'J', 'G.', 'N'),
(1012, 'A', NULL, 'P'),
(1013, 'A', NULL, 'W'),
(1014, 'N', NULL, 'A');
| 指標 | 單條循環 INSERT | 批次 INSERT |
|---|---|---|
| 網路往返 | N 次 | 1 次 |
| 解析/優化 | N 次 | 1 次 |
| 事務提交 | N 次(自動提交) | 1 次 |
| Binlog 寫入 | N 次 fsync | 1 次 fsync |
| 典型提速 | 基準 | 10x - 100x |
max_allowed_packet)START TRANSACTION; ...批次 INSERT... COMMIT; 進一步減少提交開銷LOAD DATA INFILE,速度更快# Python 批次組裝
rows = [(i, f'fn{i}', f'mn{i}', f'ln{i}') for i in range(10000)]
chunks = [rows[i:i+1000] for i in range(0, len(rows), 1000)]
for chunk in chunks:
placeholders = ', '.join(['(%s,%s,%s,%s)'] * len(chunk))
sql = f'INSERT INTO authors VALUES {placeholders}'
cursor.execute(sql, [v for row in chunk for v in row])
conn.commit()
批次 INSERT 是提升寫入吞吐最低成本、最高收益的優化手法,請養成習慣。