MySQL 中文亂碼本質是「編碼不一致」導致的解碼錯誤。本文從字符集轉換流程、關鍵系統變數、常見亂碼場景、修復步驟四個維度系統講解,助你徹底搞定編碼問題。
一次 SQL 執行涉及五次轉換:
character_set_client)轉為連接編碼(character_set_connection)。character_set_database / 表 / 欄位)。character_set_results)。任何一環不匹配皆會產生亂碼。
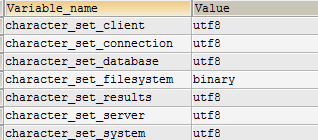
| 變數 | 說明 | 典型值 |
|---|---|---|
character_set_client | 客戶端發送語句的編碼 | utf8mb4 / gbk |
character_set_connection | 連接層編碼 | 同 client |
character_set_database | 預設資料庫編碼 | utf8mb4 |
character_set_results | 結果集返回編碼 | 同 client |
character_set_server | 服務器級預設編碼 | utf8mb4 |
character_set_system | 系統元資料編碼(固定 utf8) | utf8 |
SHOW VARIABLES LIKE 'character_set_%';
SHOW VARIABLES LIKE 'collation_%';
my.cnf/my.ini:[client] default-character-set = utf8mb4 [mysql] default-character-set = utf8mb4 [mysqld] character-set-server = utf8mb4 collation-server = utf8mb4_unicode_ci init_connect = 'SET NAMES utf8mb4'
CREATE DATABASE db CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci;charset=utf8mb4(JDBC/PDO/ORM 皆支援)。利用 latin1 單位元組覆蓋 0x00-0xFF 特性,不做任何轉換:
SET NAMES latin1; -- 等同設定 client/connection/results 皆為 latin1
若資料已寫入錯誤編碼(如 UTF-8 資料被當 latin1 存入),需「還原寫入路徑」再「按正確路徑重寫」:
-- 1. 建立暫存表,欄位設為 latin1
CREATE TABLE tmp_tbl (col VARCHAR(255) CHARACTER SET latin1) ENGINE=InnoDB;

-- 2. 以 latin1 讀出原資料(不轉碼)
INSERT INTO tmp_tbl SELECT col FROM orig_tbl;

-- 3. 將暫存表欄位改為正確編碼(MySQL 會自動按 latin1→utf8mb4 轉換)
ALTER TABLE tmp_tbl MODIFY col VARCHAR(255) CHARACTER SET utf8mb4;

-- 4. 覆蓋回原表
UPDATE orig_tbl o JOIN tmp_tbl t ON o.id=t.id SET o.col=t.col;
utf8 僅支援 3 位元組字符(BMP),Emoji 需 utf8mb4。characterEncoding=utf8,PHP PDO 需 charset=utf8mb4,Python PyMySQL 需 charset='utf8mb4'。chcp 65001 切換 UTF-8 後再連線測試。mysqldump --default-character-set=utf8mb4 導出,導入時同樣指定字符集。