結構化查詢語言 (SQL) 對關聯式 DBMS 是把雙刃劍。所有從關聯式資料庫檢索資料都需要 SQL,本文探討終端使用者、開發人員、DBA 如何高效存取關聯式資料庫。高效 SQL 使系統易升級、靈活、易管理;低效 SQL 延長回應時間與程式執行時間,產生應用系統中斷。鑑於資料庫系統通常 90% 處理時間用於檢索資料,保證 SQL 高效至關重要。檢索相同資料的 SQL 有多種寫法,不存在好/壞查詢,只有滿足需求的查詢。各關聯式資料庫有優化執行查詢的獨特方式,擁有專屬最佳效能查詢技巧。本文以 Quest Central for DB2 為例,聚焦 DB2 for OS/390 與 z/OS。
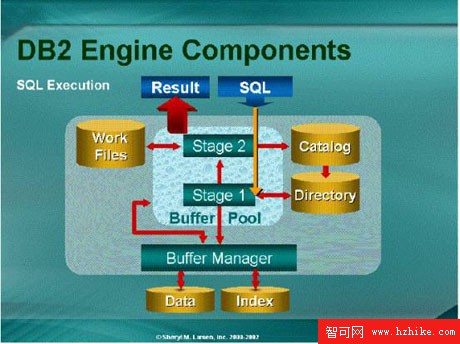
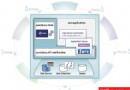
圖 1 展示 DB2 處理資料/SQL 請求流程:數據管理器(第一階段處理,擴展過濾容量)、關聯式資料服務器(第二階段處理,查詢重寫優化)、基於當前 SQL 與存取路徑決定檢索資料的 DB2 優化器。優化器每版改進,考慮目錄統計提供新/改進存取路徑。以下技巧即源於此架構。
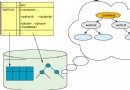
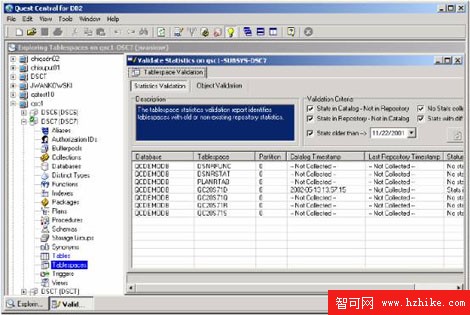
對優化器而言,除 SELECT 語句本身,DB2 目錄統計資訊為最重要資源。優化器基於眾多選擇使用統計。選擇非最佳存取路徑主因為無效或缺失統計。優化器使用目錄統計(見圖 2):表資訊(行數、壓縮、頁數)、欄位資訊(離散值、分佈範圍)、表空間資訊、索引狀態、分區資訊。
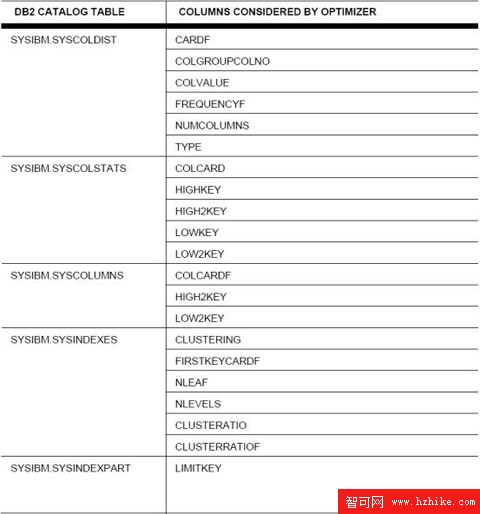
頻繁執行 RUNSTATS 更新目錄統計,在繁忙生產環境獲取全貌。為最小化影響可用採樣技術,10% 採樣通常足夠。RUNSTATS 可額外更新 1000 條目用於不均勻分佈統計,注意條目增量對所有參考綁定時間的影響。缺少統計時可手工查詢發現,優化器目前無缺失統計具體警告。
無論階段 1 數據管理器或階段 2 關聯式資料服務器處理查詢,階段 1 有巨大效能優勢。謂詞決定能否由階段 1 處理,每個謂詞被評估是否更適合作為索引路徑。部分謂詞無法作為階段 1 處理或不符合索引條件。理解查詢能否被索引且在階段 1 處理至關重要。文件化的階段 1 (Sargable) 謂詞見圖 3。
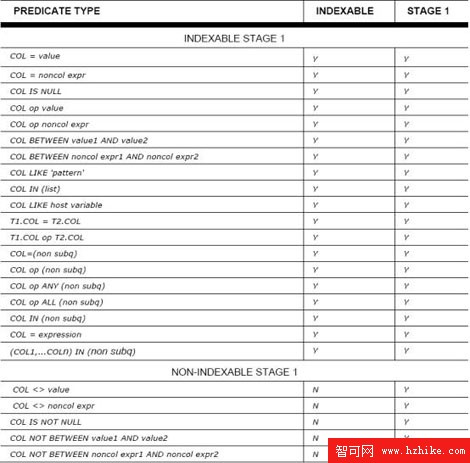
部分謂詞非文件化階段 1,因不總在階段 1。表序列與查詢重寫影響謂詞被過濾階段。範例展示重寫 SQL 影響:
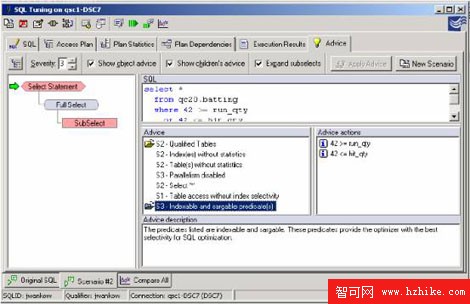
VALUE BETWEEN COL1 AND COL2 為階段 2。重寫 VALUE >= COL1 AND VALUE <= COL2 促進可索引階段 1 查詢,優化器可在多索引選擇匹配索引每個被選擇欄位必須單獨傳回調用程式,除非對整個 DCLGEN 定義有精確匹配。真正損失發生於需要排序時。每個 SELECT 欄位與重複排序欄位使排序檔更寬,檔越長越寬排序越慢。如 100,000 個 4 位元組欄位約 1 秒排序完成,10,000 個 50 位元組欄位同樣時間。實際時間高度依賴硬體。例外:「Disallow SELECT *」,當多處理需求表中行不同部分時,整合交易一次取回所有行再單獨處理各部分。
檢索行越少查詢越快。符合條件行必須在儲存器中經漫長旅程:緩衝池、階段 1、階段 2、可能排序轉換,再傳遞結果集。資料庫管理器管理所有資料過濾,對檢索一行極浪費,在程式碼測試該行再過濾。禁止程式自動過濾為鐵律。開發商可能選擇程式碼執行資料操作或 SQL,典型混合使用。已知敘述顯示過濾器可能放入 DB2 engine 程式碼類似:IF TABLE-COL4 > :VALUE GET NEXT RESULT ROW。
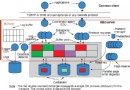
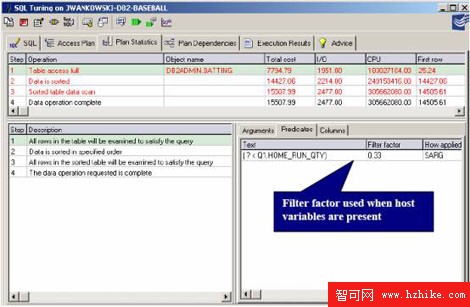
優化器充分使用所有不均勻分佈統計,為任何欄位統計提供不同領域範圍值,尤其無主機變量於謂詞時 (WHERE COL5 > 'X')。主機變量目的使交易適應可變變量,用戶請求輸入值最常用。主機變量無需重新綁定程式當變量每次改變。這種可延伸性讓優化器付出準確代價。發現主機變量 (WHERE COL5 > :hv5) 時,優化器用圖 4 圖表評估過濾器因子而非目錄統計。
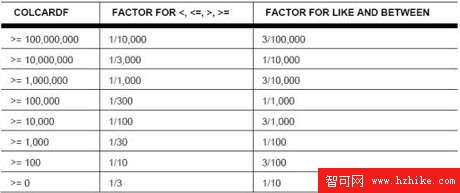
欄位基數越高,謂詞過濾器因子越低(保留部分行預測)。多數情況協助優化器選擇適當存取路徑,但有時謂詞過濾器因子偢離實際,即需調優存取路徑。
整合控制台提供 DBA 核心功能:空間管理、SQL 調優分析、效能診斷監視。由 DB2 軟體專家撰寫,豐富功能配合視覺化介面,支援 Unix/Linux/Windows 主機運行 DB2。客戶無需獨立工具維護主機與分散式 DB2 系統。
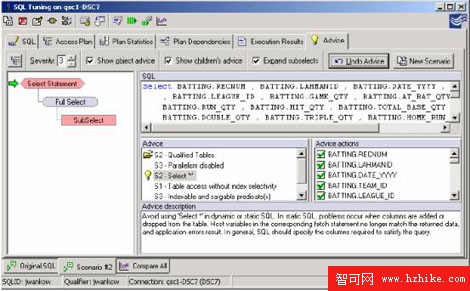
SQL 描述於 Quest Central 後,建議欄提供完整建議含無 RUNSTATS 發現能力。每建議有對應「建議操作」指導修正,開啟新場景含重寫 SQL 或促進物件分析腳本。建議顯示統計缺失與對應操作建立腳本含 RUNSTATS 命令更新選擇物件統計(見圖 5)。Space 管理自動收集維護驗證表空間/表/索引層級統計(見圖 6 統計驗證報告與 RUNSTATS 自動化介面)。
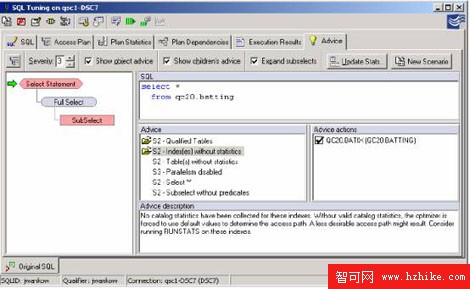
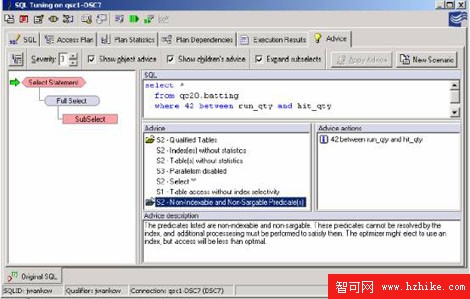
SQL 調優列出所有謂詞指明 Sargable/Non-Sargable,檢查是否具索引存取資格。單獨建議解決回應時間問題與謂詞重寫成果。範例:查詢視為 non-sargable/non-indexable (階段 2),新場景重寫用 >=/<=,比較確定重寫效能影響(見圖 7、8)。比較工具比較 <> 發現更有效減少耗時(見圖 9 耗時減半)。
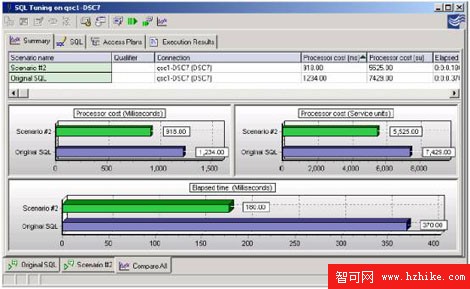
不僅有避免 SELECT * 建議,更提供事半功倍自動重寫 SQL 功能。建議與操作提供重寫能力,勾選想要欄位點選「apply advice」,SQL 調優用選擇欄位替換 *(見圖 10)。
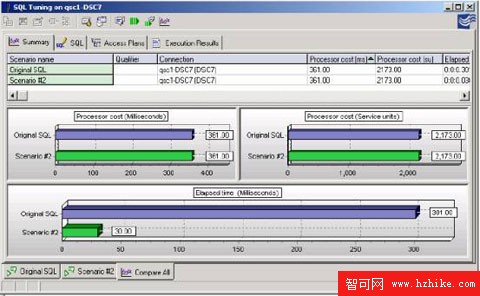
用 Quest Central 比較原始 SQL 與選擇較少行但相同語句。多場景與比較特性,立即顯示效能影響。範例:兩表連接產生有意義結果集,加入 FETCH FIRST 1 ROW ONLY 顯著減少執行時間(見圖 11、12)。
Win2K 平台 DB2 測試。使用主機變量時優化器無法預測謂詞過濾值,無此值用預設過濾器因子。Quest Central SQL 調優持續顯示每個謂詞過濾器因子協助理解過濾欄位數量(見圖 13)。
Quest Central 不僅提高 SQL 效率,更全面提升資料庫效能。上述調優技巧全被包含,由更豐富透徹知識組成。