隨著企業數據量的爆炸性增長,如何從非結構化信息(如文檔、郵件、報告)中提取結構化洞察,成為業界關注的焦點。IBM 推出的非結構化信息管理架構,提供了一個標準化框架,簡化了文本分析引擎的開發與部署,支援語義搜尋、文本挖掘等進階應用。本文將透過一個名為「Preston」的示範應用,展示如何結合 UIMA SDK 與 DB2 Intelligent Miner,從文檔中識別人名、建立關聯網絡,並發掘隱藏的實體關係。
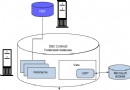
Preston 的核心流程包含三個階段:文本分析、資訊萃取入庫、關聯挖掘。系統從 DB2 資料庫讀取文檔(以 IMDB 演職員傳記為例),利用 UIMA 元件解析文本並標註人名實體,將結果寫入結構化的「萃取資訊資料庫」(EIDB),最後呼叫 DB2 Intelligent Miner 進行關聯規則挖掘,找出頻繁共同出現的人物關係。
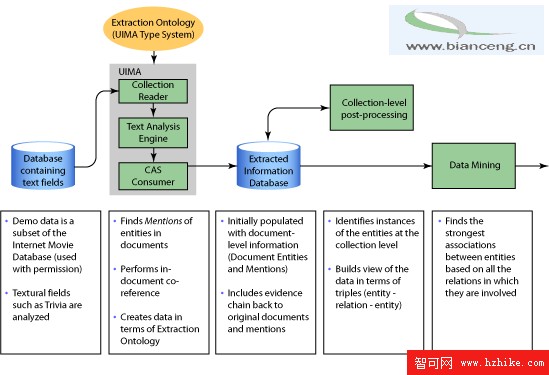
自訂的 SQLReader 實作 UIMA 的 CollectionReader 介面,透過 JDBC 連接源資料庫,執行 SELECT 語句獲取文本欄位(如 TRIVIA 欄)。每次框架呼叫 getNext() 時,SQLReader 將當前行的文本與元數據(如文檔 URI)封裝進通用分析結構(CAS)中傳遞給下游元件。程式碼結構示意如下:
public void getNext(CAS cas) {
    String content = resultSet.getString("TRIVIA");
    JCas jcas = cas.getJCas();
    jcas.setDocumentText(content);
    // 建構文檔 URI 並寫入 SourceDocumentInfo
    String id = rs.getString(idColName);
    String uri = conn.getMetaData().getURL() + "/" + tableName + "/" + idColName + "#" + id;
    SourceDocumentInfo docInfo = new SourceDocumentInfo(jcas);
    docInfo.setURI(uri);
    docInfo.addToIndexes();
    nextRow();
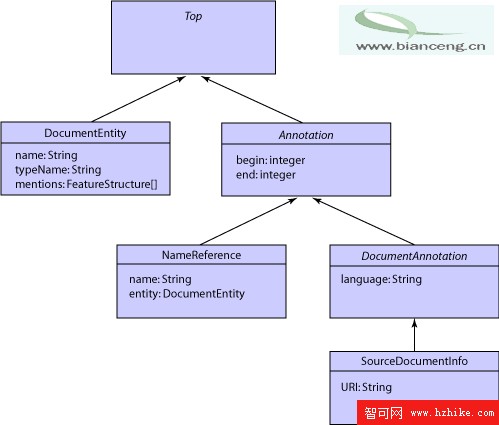
}UIMA 使用類型系統定義 CAS 中資料結構。Preston 定義了 NameReference(繼承自 Annotation)、DocumentEntity 等類型,對應文檔中的人名提及與實體。SDK 工具可自動產生對應的 Java 類別。
核心分析元件 NameReferenceAnnotator 實作 Annotator 介面,使用正則表達式偵測 IMDB 特有格式的人名:單引號包圍、後接 (qv)(如 'John Barrymore (I)' (qv))。每發現一個匹配,即在 CAS 中建立 NameReference 實例,記錄名稱字串、起訖位移,並關聯至同一文檔實體的 DocumentEntity。得益於 IMDB 命名的一致性,無需處理文內共同指代(in-document co-reference)即可準確聚合同一實體的多次提及。
Son of actor 'John Barrymore (I)' (qv) and actress 'Dolores Costello' (qv).處理完所有文檔後,兩個 CasConsumer 依序接收最終 CAS:
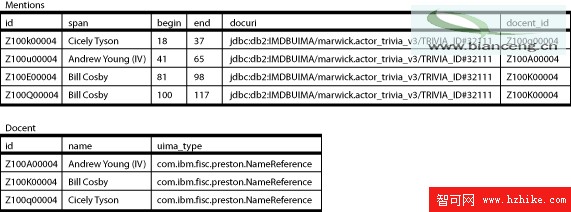
NameReference、DocumentEntity 寫入關聯資料表 MENTIONS、DOCENT。配置範例如下:<explicitMappingRule applyToSubtypes="false">
<type>com.ibm.fisc.preston.NameReference</type>
<table>MENTIONS</table>
<featureMappings>
<featureMapping>
<feature>name</feature>
<length>1024</length>
<column>SPAN</column>
</featureMapping>
<featureMapping>
<feature>entity/com.ibm.fisc.preston.DocumentEntity:uniqueId()</feature>
<column>DOCENT_ID</column>
</featureMapping>
</featureMappings>
</explicitMappingRule>collectionProcessComplete 階段執行跨文檔共同指代(cross-document co-reference),將不同文檔中指向同一現實人物的 DocumentEntity 連結至統一的 INSTANCES 表,建立 DE_INST 關聯表。IMDB 命名一致性使此步驅僅需兩條 SQL 即可完成。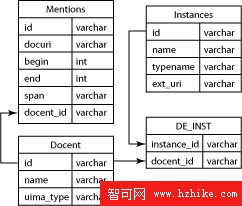
核心假設:若兩人在同一文檔中被提及,即存在關聯證據。為配合 DB2 Intelligent Miner,將 EIDB 資料轉換為「垂直模式」視圖 UIMA_RELATIONS(主體-謂詞-對象三元組),再自連結產生挖掘視圖 MINING_VIEW,包含 name(實體名稱)與 transaction_id(文檔 URI)兩欄,對應市場籃子分析中的「商品」與「交易 ID」。
| 欄位 | 說明 |
|---|---|
| subject_type | 主體實體類型(如 NameReference) |
| subject_uri | 主體實體唯一識別碼(URI 形式) |
| predicate_type | 謂詞類型(如 Has_name、Mentioned_in) |
| object_type | 對象類型(Document 或 String) |
| object_name | 對象 URI 或字串值 |
| evidence_uri | 證據文檔 URI |
呼叫內建儲存程序 IDMMX.BuildRuleModel,設定最低支援度 0.01%、最低可信度 1%、最大規則長度 2:
CALL IDMMX.BuildRuleModel('PRESTON', 'MINING_VIEW', 'TRANSACTION_ID', 0.01, 1, 2)挖掘輸出生成 personA => personB 形式的規則,強度由支援度(共同出現比例)與可信度(條件機率)衡量。視覺化工具繪製的強連通子圖清晰揭示披頭四樂隊成員及其緊密關聯人物群(如下圖,橙色>白色>藍色表示關聯強度遞減)。
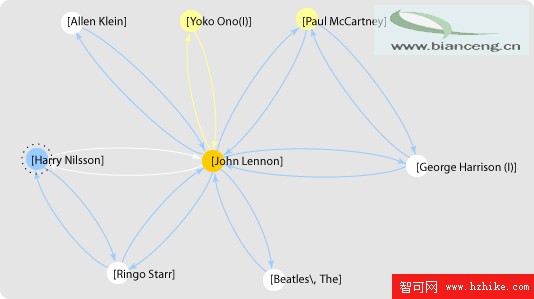
Preston 雖屬教學範例,卻完整展示了「非結構化 → 結構化 → 智慧洞察」的端到端流程,證明 UIMA 與 DB2 結合在文本挖掘場景的強大潛力。