首頁
編程語言
C語言|JAVA編程
Python編程
網頁編程
ASP編程|PHP編程
JSP編程
數據庫
MYSQL數據庫|SqlServer數據庫
Oracle數據庫|DB2數據庫
您现在的位置: 程式碼之家 >> 數據庫知識 >  >> DB2 資料庫 >> DB2 教學

DB2 Warehouse 9.5 文本分析實戰:從非結構化數據到 OLAP 多維洞察

     編輯:DB2 教學

背景:非結構化數據的商業價值

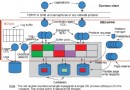
呼叫中心紀錄、問卷回饋、維修報告、病歷、保險理賠……企業 80% 以上數據為非結構化文本。DB2 Warehouse 9.5 引入 Unstructured Analysis (UA) 組件,專注於**信息提取**,將文本轉為結構化數據,再結合數據挖掘與 OLAP 進行深度分析。

文本分析三大流派與 UA 定位

  • 文本檢索:關鍵字搜尋,需明確知道要找什麼。
  • 文本分類:自動歸類文檔,但仍需人工細讀。
  • 信息提取(UA 核心):從文本自動抽取實體、術語、情感等結構化信息,無需預先知道所有查詢目標。

UA 支持的提取技術

  • 基於規則:正則表達式匹配電話、郵件、產品代碼等固定模式。
  • 基於字典:枚舉人名、地名、產品名等實體詞彙。
  • 進階算法:NLP、機器學習、統計模型(UA 以規則與字典為主)。

實戰案例:電信客戶興趣愛好與流失傾向分析

1. 數據準備與探查

執行附件 `instDB.bat` 建立範例數據庫 `TELE`,含用戶基本資料表 `DW_USER_COLLECT`(欄位 `HOBBY` 存放興趣愛好文本)與通話詳單。在 Design Studio 使用 Data Exploration 查看樣本內容、文本統計(長度、詞頻)、多變量分布。

2. 常用術語抽取

對 `HOBBY` 欄位執行 Frequent Term Extraction,自定義詞性模式「任意-名詞」捕捉詞組(如 "play football"),結果按絕對頻率排序,輔助建立業務字典。

3. 建立業務字典

從抽取結果選取相關術語生成字典 `HOBBY_DIC`,人工合併同義詞(jogging/running → 跑步)、分類歸屬(球類運動),提升匹配精準度。

4. 設計挖掘流

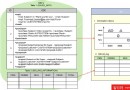
  • MF_HobbyDimension:Table Source → Dictionary Lookup (HOBBY_DIC) → Distinct (去重) → Select List (產生 HOBBY_ID) → 建立維表 `DIM_HOBBY`。
  • MF_HobbyFact:同源表 Join `DIM_HOBBY` 依 HOBBY 鍵值 → 產生事實表 `DW_USER_HOBBY`(含 USER_ID、MONTH、HOBBY_ID)。

5. 控制流與應用部署

建立 Control Flow `CF_HobbyCreation` 串聯兩個挖掘流 → 產生 Data Warehouse Application `HobbyCreate_APP.zip` → 部署至 DB2 Warehouse 管理主控台 (port 9060) → 配置資料源 JNDI → 排程執行。

6. OLAP 整合

維表 `DIM_HOBBY` 與事實表 `DW_USER_HOBBY` 可直接用於 Cubing Services 建立多維立方體,結合通話時長、業務類型等結構化指標,實現「興趣愛好」維度的多維切片分析。

總結

DB2 Warehouse 9.5 UA 提供「字典+規則」的可視化文本分析管線,無需寫代碼即可完成從原始文本到 OLAP 就緒數據的全流程,極大降低非結構化數據利用門檻。

  1. 上一篇文章:
  2. 下一篇文章:
Copyright © 程式碼之家 All Rights Reserved